
用AI怕泄密,不用怕落后,这道题有解吗?
一位员工赶一份汇报,把内部合同的原文整段贴进了AI对话框,对方公司名、金额、毛利率、经办人姓名都在里面。
总结很快出来了,他关掉窗口,事情看起来结束了。
但这份合同并没有停在那一次对话里。
它离开了公司内网,进了第三方服务器,成了某个模型上下文的一部分。
会不会被留存、被关联、被拿去训练,他并不知道,也查不到。
过去担心大模型说错,现在还要防止它做错。
如果企业用的不是聊天窗口,而是一个连着文件、邮件和业务系统权限的智能体,它可能改错一份正在跟进的合同,误删重要资料,或者把敏感内容发给了不该收的人。
在政企场景里,模型可以接、预算可以批,但“数据出去之后谁看得到”这一问答不上来,后面的事就很难推进。
9月14日,《人工智能安全治理框架3.0》正式发布。
它把治理视角从单一技术环节,拓展到数据、算法、模型、应用供应链的全过程,并明确提出“最小权限”。
瑞莱智慧是该权威指引文件发布方全国网络安全标准化技术委员会的成员单位,长期参与人工智能安全相关标准的编制工作。
真正的问题, 不在“能不能调用云端模型”
企业里的一次大模型调用,请求里包含的信息远比想象中多:内部知识、业务数据、客户信息、代码、流程上下文,甚至系统权限。 哪些任务可以上云? 哪些数据可以出去? 出去到什么程度? 什么必须留在本地? 这四个问题,才真正决定一次调用该不该走云端。 把请求送进模型、把结果取回来,是模型调用服务的常规动作。 难的是送出去之前那一步,要判断哪些内容能出去、以什么形式出去、交给哪个模型。 国家安全部此前在官方微信公众号通报过一起案例:某单位工作人员处理内部文件时违规使用开源AI工具,因系统默认开启公网访问且未设密码,敏感资料被境外IP非法访问、下载。 2026年9月15日,国家网信办通报的执法典型案例中,既有企业以“API中转站”方式调用多个大模型接口、未按规定开展安全评估而被处罚,也有企业因未申报数据出境安全评估即向境外传输个人信息被罚款。 两天后,公安部发布的网络安全行政执法典型案例显示,“护网—2026”专项中,全国侦办不履行数据安全、个人信息保护义务类行政案件已达3.8万起。 企业需要的,是一条既能用上大模型、又不越过安全线的路径。
为什么“全部搬进自己机房” 并不是答案
把所有模型都部署进自己的机房,是一条正在变窄的路。 斯坦福大学《2026年人工智能指数报告》显示,受调查组织的AI采用率已达88%,而记录在案的AI事故从2024年的233起升至2025年的362起。 报告把“能力与治理”之间的落差,称作当前AI领域最核心的挑战。 过去三年,模型规模连跳四个台阶:百亿级、数百亿级、千亿级,再到万亿级。 按公开的模型卡与显卡官方规格估算,仅权重显存需求就从几十GB涨到数TB。 这对企业来说,是四重门槛同时抬高。 硬件门槛:显存、互联带宽、机房电力。 工程门槛:模型适配、并行切分、集群调优。 成本门槛:前期投入高、升级周期短。 迭代门槛:模型更新快、本地能力滞后。 能装载,不等于能高效稳定运行;迭代也是更高的门槛。 企业自建的模型,往往刚上线就开始落后,很难用上最好的那一批。
瑞莱智慧的回答: 中枢词元NexToken平台
对于这些现实难点、痛点,瑞莱智慧的答案是:中枢词元NexToken平台。
它是面向企业与开发者的一站式AI安全能力底座,部署在用户与本地及云端模型之间,是AI请求的统一安全入口、智能决策中枢和结果出口。 其最核心的对外主张是用Token,但数据不出域。 具体做法是:敏感数据与业务逻辑留在本地,超大模型能力通过云端按需调用,中间由隐私保护、可信路由与全程审计把两端接起来。
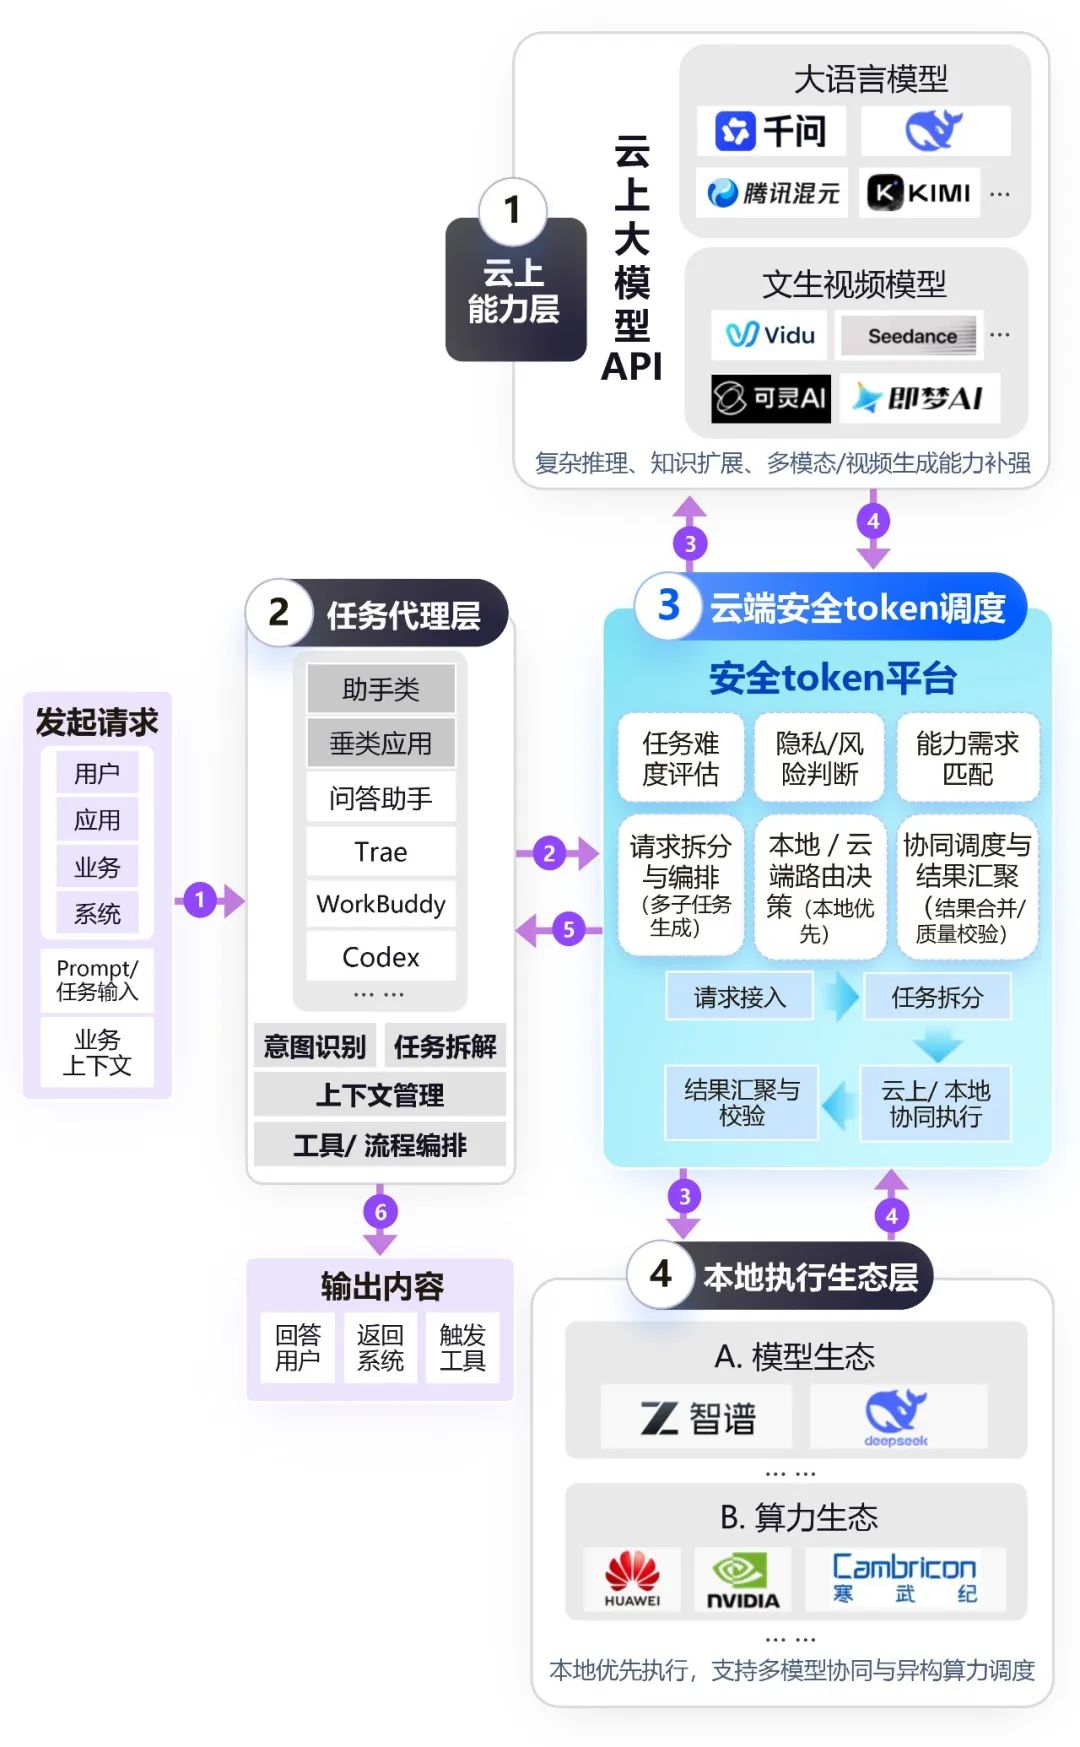
从接入到回填的完整链路
一次请求在NexToken里依次经过请求接入、任务拆解、数据处理、模型路由、工具执行、结果返回六个环节。 下面以一条对账请求为例。 第一步:一句普通的业务请求。 帮我对一下账:我们和华瑞制药今年Q3签的原料药采购合同,金额4,860万元、毛利率31.5%;去年和康泰生物的同类型合同是3,200万元、毛利率27.8%。另外下周五要在上海张江研发中心,和对方采购总监张明开「猎鹰计划」启动会。请帮我:1)分析两笔合同的盈利变化;2)起草一封发给张明的会前确认邮件,邮件里提到我们CEO王建国也会出席。
短短一段话,藏着公司名、合同金额、毛利率、办公地点、客户姓名、项目代号和CEO姓名。
演示请求原文,敏感实体被标出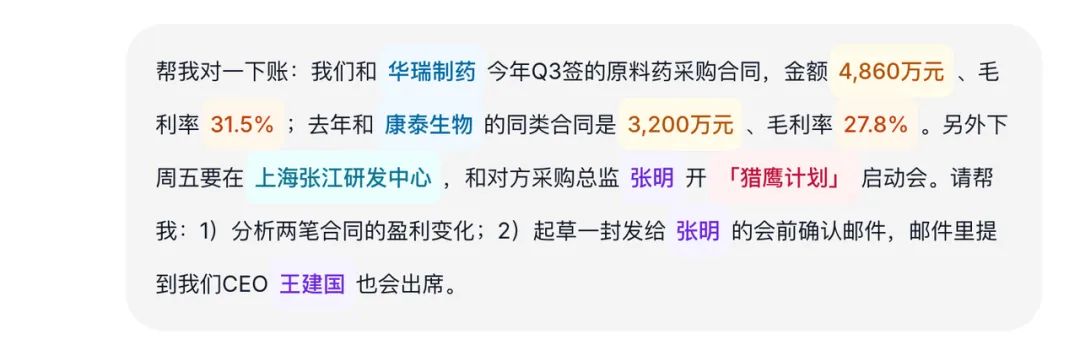
第二步:直接问云端大模型。 这些内容会被完整上传给第三方云端。 图里标出的地点、两家公司、项目名、两笔金额、两个人名、两个毛利率,共10类信息,会一个不落地送出去。 这既触碰《个人信息保护法》《数据安全法》的合规要求,也可能让商业机密进入第三方的训练语料。 第三步:走NexToken。 请求先到NexToken。平台按最小必要披露原则,对请求做字段裁剪、脱敏、匿名化与占位替换,复杂的再拆成可独立执行的子任务。 智能路由综合任务难度、隐私等级、模型能力、输出质量、响应时延与调用成本,决定这条子任务走本地、走私有算力还是走云端。 高敏感数据与核心处理留在本地。 只有必须借助云端能力的子任务,才把完成任务所需的最少信息送出去。 于是,云端模型收到的是: 帮我对一下账:我们和[COMPANY_001]今年Q3签的原料药采购合同,金额[AMOUNT_001]、毛利率[RATIO_001];去年和[COMPANY_002]的同类型合同是[AMOUNT_002]、毛利率[RATIO_002]。另外下周五要在[LOCATION_001],和对方采购总监[PERSON_002]开[PROJECT_001]启动会。请帮我:1)分析两笔合同的盈利变化;2)起草一封发给[PERSON_002]的会前确认邮件,邮件里提到我们CEO[PERSON_001]也会出席。
实际发送至云端的内容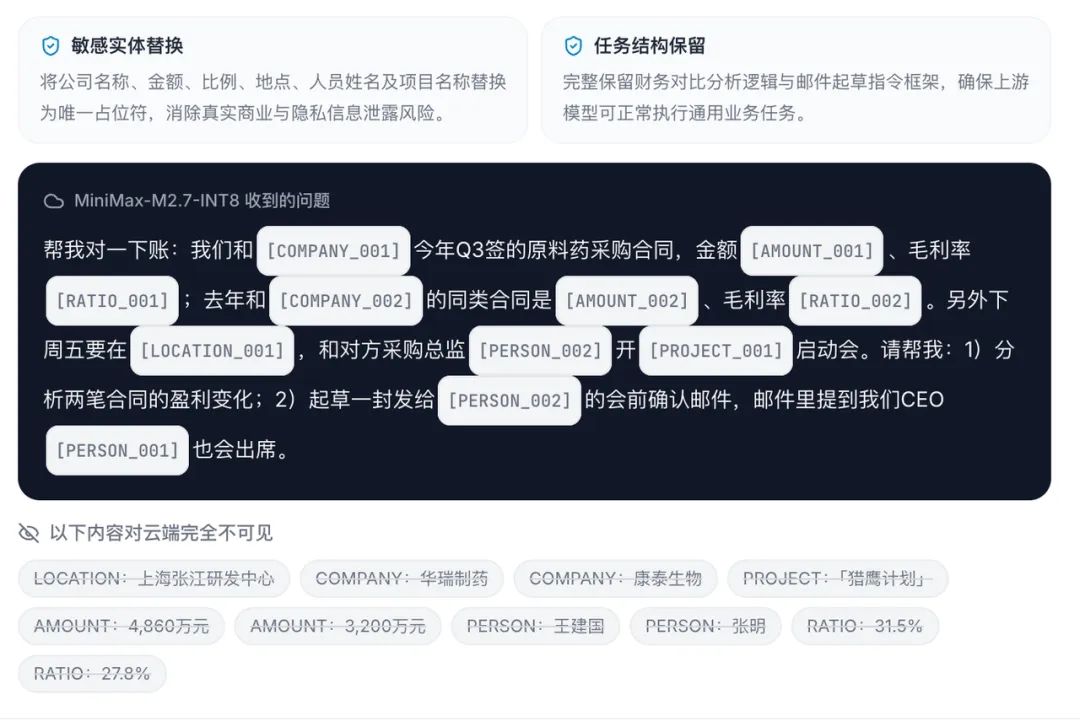
这其中的取舍是,敏感信息被完整遮蔽,任务指令则原样保留。 两笔合同的对比分析逻辑、邮件起草的指令框架完整保留,云端模型因此仍能完成这项任务。 替换规则与变量映射只存在于本地安全沙箱,云端无法逆向还原原始问题。 一轮对话下来,11处敏感信息命中并保护(10个唯一值)、识别出6类敏感类型、明文敏感数据发往模型0字节。 第四步:结果怎么回来。 云端结果不会直接透传给用户,它再次经过NexToken,完成内容安全检查、敏感信息检测、质量校验与风险拦截。 必要时由本地模型复核、纠错或聚合,并在受控环境中完成占位信息恢复,把真实数值填回去。 用户拿到的,是一份完整可用的结果。 出去的是占位符,回来的是一份能用的答案,原始数据全程留在本地。
数据分五级, 等级越高越往本地走
把数据一刀切地留在本地,业务就没法用; 一刀切地放出去,风险又兜不住。 NexToken的做法是把数据分级:L0公开数据、L1内部数据、L2敏感数据、L3高敏感数据、L4核心限制数据。 等级低的可以受控上云。中间的先脱敏、做最小披露再出门。高的默认留在本地,确需云端能力时拆成最小子任务、走严格授权。最高一级原则上禁止外发。 等级越高,处理越向本地收敛。 分级直接驱动路由:高敏留端,复杂上云。
审计链:每一次请求都可回溯
NexToken用唯一任务标识贯穿每一次请求,把请求接入、隐私处理、模型调用与结果返回串成一条审计链。 管理人员可以按用户、时间、任务状态、模型或隐私等级查询追溯。 其中一项叫“请求差异”,平台同时记录收到的原始请求与处理之后实际发给模型的请求,并展示两者的差异,同时记录命中的数据等级、敏感字段与处理动作。 它不只知道“发了什么”,还能回答“实际向模型披露了什么”。
这对企业意味着什么
一是敏感数据不外流,《人工智能安全治理框架3.0》提出的“最小权限”与“全生命周期审计”,已内化为产品的默认机制。 二是云端大模型正常用,不必在“安全”和“最新能力”之间二选一。 跟全部私有化部署相比,端云协同更现实:全私有化确实更安全、响应也更快,但成本极高,也几乎注定跟不上大模型的迭代速度。 三是全过程可追溯,事后经得起内部保密与合规检查。 回到开头那个场景: 那份合同会不会离开内网、会不会被留存,不应该交给一次随手操作去决定。 NexToken给出的思路是把这条边界再往前挪一步:先判断哪些数据根本不必出去,再去谈怎么用。 当安全的边界画在企业的门口,大模型的能力才真正进得来。 让企业放心用AI,让AI更好用,这是中枢词元NexToken正在做,且必须做到的事。