
火种说|AI 在后台帮你干活时,还能随时被你打断吗?这个开源模型想让 Agent "边做边聊"
过去几期「火种说」,我们记录了好几位开发者用 MiniCPM-o 4.5 做出来的新物种:能察言观色的桌面陪伴机器人、一直看着屏幕的本地 AI"贾维斯"。它们共同的底座,是 MiniCPM-o 4.5 的全双工实时交互能力——能听、能看、能判断什么时候该开口。
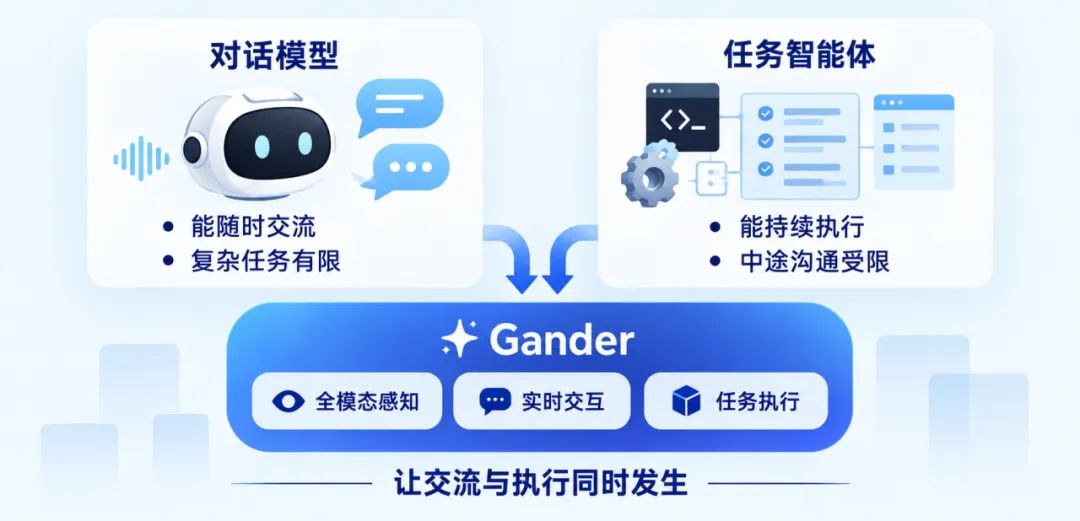
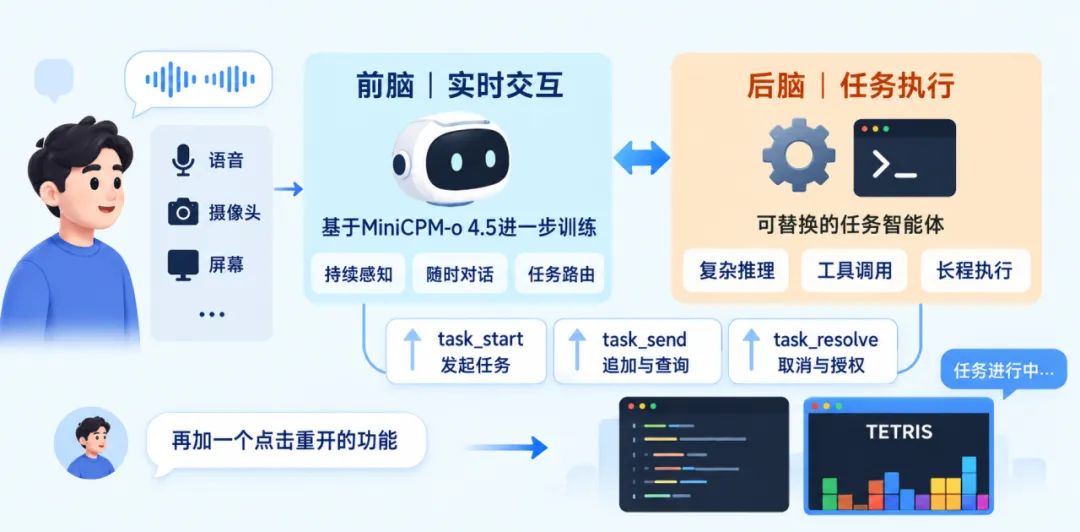
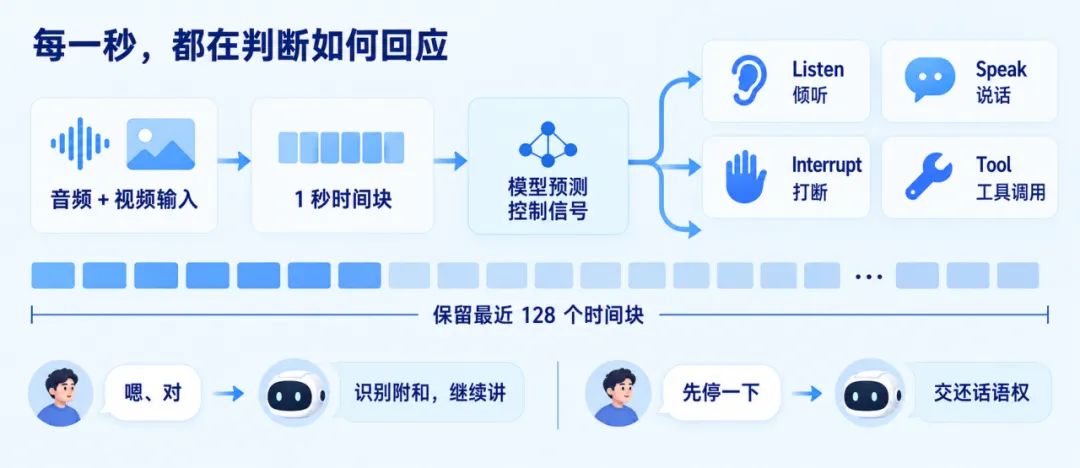
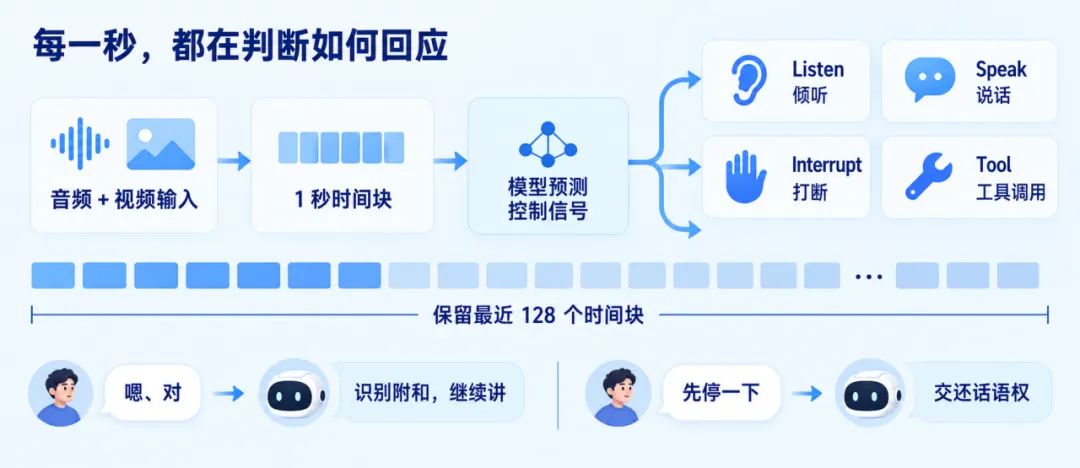
这一期的火种有些不同。这一次,一群外部研究者站到了 MiniCPM-o 4.5 的肩膀上:以它为初始化基座继续后训练,沿用它标志性的 Thinker-Talker 全双工架构,往一个更难的问题发起了冲击:当 AI 不只是陪你聊天,而是真的动手帮你干活时,"实时对话"还能不能保留下来? 他们交出的作品,是一个端到端的全模态交互智能体——Gander,论文、数据、代码、模型和 Demo 全部开源。 01.会干活的"失联" 会聊天的"不干活" 先还原一个几乎每个人都遇到过的场景。 你对一个 Agent 说:"帮我查一下上海周边适合拍摄的地点,比较一下各自的优缺点。"它开始检索、整理,一跑就是几分钟。这几分钟里你突然想起两件事:预算最好控制在一千元以内;另外,你想知道它现在查到哪一步了。但大多数 Agent 此刻是"失联"的——任务不结束,你插不进话,只能干等,或者干脆新开一轮对话把需求重说一遍。 问题的根源在于,当下的 AI 被劈成了两半。 一半是对话模型。从传统的"语音识别—大模型—语音合成"三段式流水线,到最新的全双工语音模型,它们越来越会"聊天":能被打断、会附和、反应越来越像真人,但基本停留在问答层面,做不了需要多步规划、调用工具、持续执行的复杂任务。 另一半是任务智能体,比如各类 Coding Agent。它们能检索、能读写文件、能跑通一个长任务,但交互是文本的、轮次的、异步的——它埋头干活的时候,没有一只"耳朵"一直对着你。 Gander 的作者在论文开篇,把这件事归纳成两个绕不开的问题:第一,真正自然的交互,能不能靠 VAD(语音活动检测)、ASR(语音识别)这些独立模块拼装出来?还是说,"交互能力"本身必须长进模型里?第二,一个模型能不能同时满足实时交互需要的"快",和复杂任务需要的"深"? 他们给出的答案,是一个把 Omni(全模态感知)、Interaction(实时交互)、Agent(任务执行)三条线融合在一起的端到端模型。 Gander的探索和训练基于 MiniCPM-o 4.5 提供的一套地基: 标志性的 Thinker-Talker 架构:Thinker 负责语义理解和文本生成,Talker 负责语音合成。 Omni Flow 的连续交互思想:把多模态输入和输出摆上同一条时间轴,边生成回应边持续感知,并在恰当的时机主动开口。 在这块地基上,Gander 只加了两样关键的东西,却恰好补上了从"会聊天"到"会干活"的缺口:一样是把"何时听、何时说、何时打断"变成模型逐秒原生预测的流式块扁平化,另一样是把实时交互与长程任务解耦的前脑—后脑协作框架。需要说明的是,Gander 与 MiniCPM-o 并非同一团队的作品,而是外部研究者站在开源基座肩膀上做出的后续探索——这本身,也是开源最有生命力的地方。 02.前脑管"陪你说话" 后脑管"埋头干活" Gander 的第二处关键扩展,是一套"前脑—后脑"协作架构(论文里称为 Cerebellum–Brain,小脑—大脑),它要解决的,正是"既能随时聊、又能埋头干"这对矛盾。 前脑,是一个基于 MiniCPM-o 4.5 进一步训练的实时全双工全模态模型,是用户始终面对的那张"脸"。它持续接收语音、摄像头和屏幕画面,负责日常对话、简单的检索类小任务,以及一件更关键的事——判断"这件事我自己处理,还是该交给后脑"。 后脑,是一个无需训练、即插即用的通用任务智能体,负责复杂推理、工具调用和长程任务,默认用 Codex 实现,也可以替换成 Claude Code 这类更强的执行器。正因为它不绑定具体模型,未来后脑可以不断升级,而前脑一行都不用重训。 两层之间,不靠人工写死的规则调度,而是由前脑通过结构化的 tool call 来触发,对应三个动作:task_start 发起一个后台任务,task_send 在任务进行中追加信息、修改要求或查询进度,task_resolve 则负责取消、授权这类生命周期控制。 于是,开头那个"失联"的场景被改写了。项目主页的 Demo 里,用户先用语音让 Gander 写一个 HTML 俄罗斯方块游戏,后脑开始搭建;等待期间,用户继续说"再加一个点击重开的功能",又直接共享游戏画面,指着按钮说"把暂停键换个配色"。语音、画面和任务推进,始终交织在同一条时间线上——它在后台干活的同时,和你的对话一秒都没有中断。 你可以补充约束、可以分叉出一个不影响主任务的只读小问题,也可以随时喊停。 03."什么时候听、什么时候说" 是模型自己学出来的 前脑要做到这一切,最难的不是"会说",而是"知道什么时候该说、什么时候该闭嘴"。 传统流水线把这个决定权交给外挂的 VAD:靠声学信号判断你说完了没有。但人说话有停顿、有犹豫、有"我先说一句啊"这种发语词,单纯靠"安静了几秒"来判定话轮边界,要么频繁抢话,要么反应迟钝。级联流水线在基准测试里抢话率高达 33%,正是这个原因。 Gander 的第一处关键扩展,就是把交互决策直接做进模型内部。在沿用的 Thinker–Talker 架构之上,它设计了一套"流式块扁平化"(chunk flatten)机制:把连续交互切成每秒一个时间块,每个块先"看"完这一秒进来的音频、视频 token,再由模型自己预测一个控制 token——是继续倾听(Listen)、开口说话(Speak)、被打断(Interrupt),还是发起工具调用(Tool)。模型保留最近 128 个时间块,形成大约两分钟的滑动上下文。 换句话说,倾听、说话、打断、附和,不再是外部模块的开关,而是模型逐秒生成的预测结果。 这让一系列真实而棘手的交互形态成为可能,Demo 里都能看到: 打断与附和:你简短地"嗯""对"一声,它知道这是 backchannel(附和),会继续讲下去;你明确要求停下,它才把话语权交回来。 主动交互:你只需说一句"看到企鹅的时候告诉我",它就会持续盯着视频,在企鹅出现的瞬间主动提醒,而不是等你再来问。 抗干扰:周围有不相干的人说话,它能判断哪句是对自己说的。Demo 里,背景人声嘈杂,它依然稳稳地接着讨论"护照丢了怎么办"。 多人对话:两个人讨论出游计划,它能分清"刚才说出发时间的是哪一位",并据此回答追问。 这些能力不是凭空"涌现"的,而是用数据一点点教出来的。Gander 的训练语料约 270 万条,分成四族:语音交互、音视频交互、智能体交互,以及抗干扰与负样本。仅全双工交互子集 InteractionSpeech 就有 26.08 万段对话,由专门的流水线合成——每段对话里,打断从哪里开始、附和落在哪个字上,都在时间线上被精确标注;还有 11.2K 个场景与话题种子,覆盖教育、医疗、出行、金融、客服等 45 类日常场景。为了让模型"学会安静",团队还专门构造了"没有指令的环境"和"无关画面"这类负样本。 效果体现在 Full-Duplex-Bench v3 的 100 个场景里:Gander 的适时接话率达到 100%,而提前抢话率只有 8.0%——作为对照,GPT-Realtime 是 13.5%,最弱的基线高达 47.9%。要知道,这是一个 9B 规模的模型,在"全双工架构最该赢的那条赛道"上,赢过了六个商业与开源系统。 04.一套 Harness 把"对话"和"干活"缝成持续协作 如果说前脑解决了"聊得自然",那么让任务真正跑得可靠的,是夹在两脑之间的智能体编排运行时(Agent Orchestration Runtime)——也就是团队反复强调的那套 Harness。 它像一个严谨的调度中枢,围绕 Project、Task、Run、WorkerEvent、Delivery 五个持久化实体来组织后台执行:任务状态怎么流转、多个任务怎么并发、工作区怎么隔离、权限怎么管控、结果怎么送达,都由它统一负责。前脑发出的 task_start / task_send / task_resolve,会被绑定到传输层确认过的"真实用户指令"上,而不是模型自己生成的一段参数——这避免了模型"自作主张"地发起任务。 几个细节很能体现这套设计的工程味:授权被细分为"仅这一次"(allow_once)和"整个任务期间"(allow_session),也可以直接拒绝;用户随口问的支线问题,会在一个隔离的 fork 里只读执行,绝不污染主任务的状态和工作区;后脑在执行中发现的重要进展,可以通过 share 接口回传给前脑,前脑再用自然口语而不是一段冷冰冰的任务日志讲给你听。 正是这套 Harness,把"发起任务—执行中改需求—进度回传—澄清—授权—取消—交付"串成了一个完整闭环。实时对话与任务执行,第一次被缝合成了一场持续进行的协作,而不是一次次割裂的问答。 05.一份诚实的成绩单 和还没填平的坑 在任务准确率上,端到端的 Gander 目前仍落后于表中的商业系统:严格的 Pass@1 为 0.400。但团队做了一个很有说服力的对照——绕过前脑和语音通道,直接用用户文本驱动同一个后脑,Pass@1 立刻升到 0.520,工具选择准确率达到 0.934,超过了表里所有系统(包括 GPT-Realtime 的 0.876)。这说明瓶颈不在"两脑分工"的架构,而在语音识别转写和任务路由的训练配方上,是可以靠迭代数据和流程补回来的。 全模态理解也类似:相比初始化基座模型 MiniCPM-o 4.5,Gander 在 WorldSense 上回落了 6.08 分,但在更看重"音视频随时间联合推理"的 Daily-Omni 上只回落 1.67 分,而且音视频一起输入比任一单模态高出 19.13 个百分点。换句话说,交互训练保住的,恰恰是它反复练习的那种"跟着流动的画面和声音一起理解"的能力。 论文最后,作者还列出了一串开放问题:两脑之间目前主要靠 ASR 转写文本沟通, richer 的双向信息传递还没做;长任务带来的记忆与长上下文管理仍是难题;面向"全模态交互智能体"的统一评测基准,整个领域都还缺一块。这些"踩过的坑",都被原原本本写进了报告里。 06.开源,以及它带来的启发 Gander 的论文、数据、代码、模型权重和全部 Demo 都已开源。 项目的核心作者季圣鹏,来自浙江大学 DCD 实验室,此前曾参与 Qwen-Omni 模型的研发,代表作是高效音频分词器 WavTokenizer(ICLR 2025),在 GitHub 上收获了超过 1.3k star;Gander 的作者团队还汇集了上海交通大学、香港中文大学、南洋理工等高校的研究者。 而对整个端侧与开源社区来说,Gander 最有启发的一点在于:一个像 MiniCPM-o 4.5 这样的实时全模态模型,可以成为复杂 Agent 系统的"统一交互入口"。 过去我们习惯为 Agent 单独做一套文本对话框,再为语音助手单独做一套只能闲聊的皮囊;Gander 证明了,实时感知与对话本身就可以是 Agent 的前台——复杂的推理和执行交给可替换的后脑,而与人打交道的那张脸,始终专注、始终在线、始终接得住你的每一次插话。而 Gander 与 MiniCPM-o 并非同一团队这一点,也让这份探索多了一层意味:一个足够开放的实时多模态基座,完全可以被另一群人接过去,长出基座作者都未曾预设的新方向。 模型从来不是终点,而是起点。当实时交互的能力被彻底打开,Agent 与人协作的形态,也许才刚刚开始演化。下一个惊喜,可能就在你手中。