
达观数据在国际人工智能与神经网络权威学术期刊发表知识工程科研论文
一、论文主要内容和要解决的核心问题
1. 研究背景与问题定义
知识蒸馏(Knowledge Distillation,简称KD)是一种模型压缩技术,核心思想是将一个复杂的教师网络的知识迁移到一个轻量级的学生网络中,使小模型能达到接近大模型的性能。
传统的知识蒸馏依赖于原始训练数据集。但在实际应用中,这些数据常常因隐私保护、商业机密或传输限制而无法获取。
为了解决这一痛点,无数据知识蒸馏(Data-Free Knowledge Distillation,简称DFKD)应运而生。DFKD的目标是在不使用任何原始数据的情况下,仅通过教师网络本身来训练学生网络。
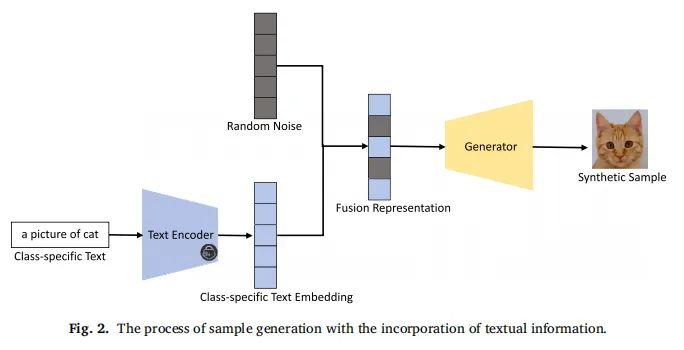
图1 结合文本信息的样本生成过程
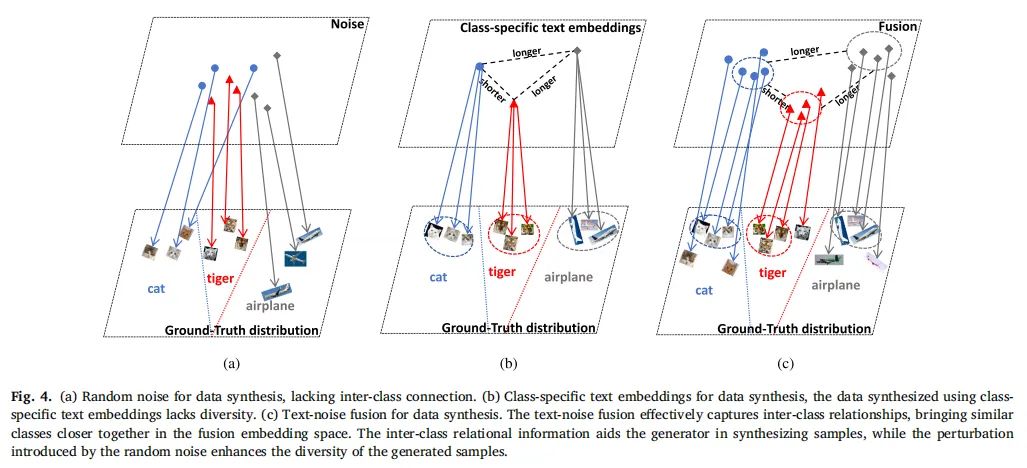
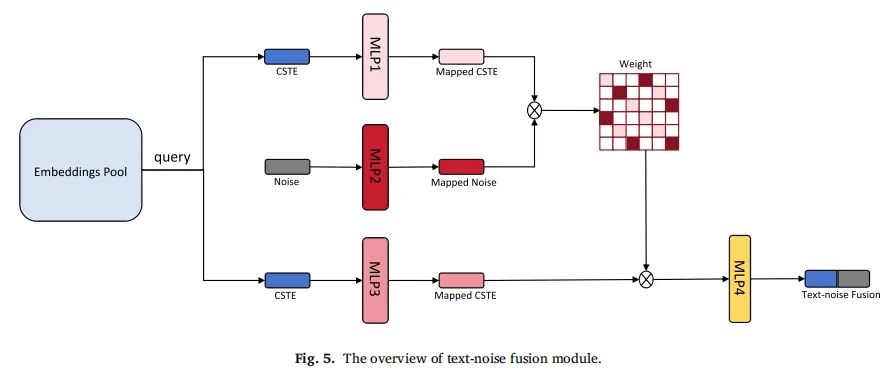
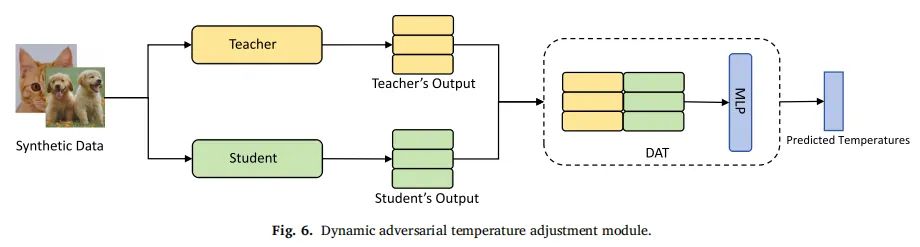
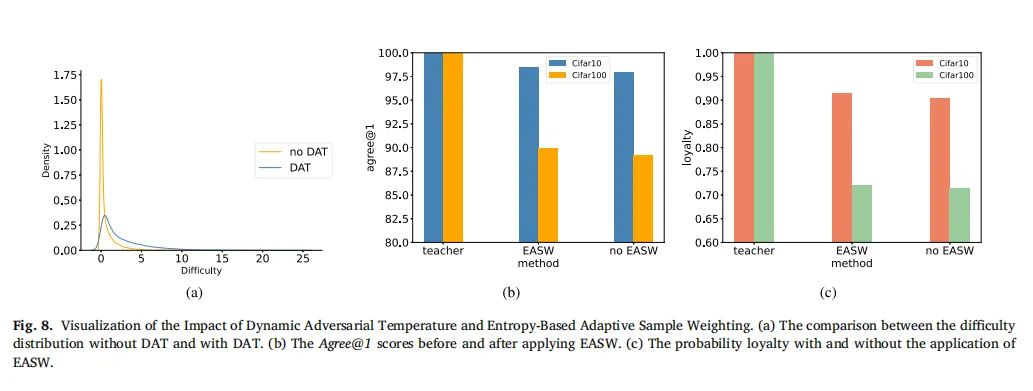
2. 现有方法的局限性与论文要解决的问题 问题一:样本质量低,即缺乏语义信息。纯粹的随机噪声不包含任何有意义的类别信息,比如猫和狗的区别。生成器很难仅从噪声中学习到真实数据的复杂分布,导致生成的样本质量差,影响学生网络的学习效果。 问题二:样本多样性不足,即蒸馏难度单一。在生成器的对抗训练中,温度(Temperature)是一个关键参数,它控制着教师网络输出概率分布的软硬程度,直接决定了合成样本的蒸馏难度。现有方法都将温度设为一个固定的超参数,导致生成的样本难度单一,限制了学生网络泛化能力的提升。 针对上述问题,作者提出了TNFDAT方法,如下图所示,其核心创新体现在三个模块: 图2 TNFDAT整体框架:用文本语义引导无数据蒸馏 1. 文本-噪声融合模块(Text-Noise Fusion Module) 思想:既然纯噪声缺乏信息,那就给它注入知识。作者利用预训练文本编码器(例如CLIP的文本编码器)将类别名称(比如猫、汽车)转换为类别特定文本嵌入(Class-Specific Text Embeddings,简称CSTE)。这些嵌入向量包含了丰富的类别间语义关系,例如猫和老虎的向量距离比猫和飞机的距离更近。 图3 纯噪声缺语义,纯文本缺扰动,文本-噪声融合同时补足质量与多样性 实现:设计了一个可学习的融合模块,而非简单的拼接或加权求和,来动态地将随机噪声与CSTE融合。生成的融合向量既包含了语义信息(来自文本),又保留了随机扰动(来自噪声),从而引导生成器生成高质量且多样化的样本。 图4 文本-噪声融合模块概览 2. 动态对抗温度模块(Dynamic Adversarial Temperature,简称DAT) 思想:将生成器对抗训练中的温度参数从一个固定的超参数变成一个可学习的参数。作者设计了一个由多层感知机(MLP)构成的温度调节模块。 实现:该模块以教师和学生的输出为输入,动态预测当前最合适的温度值。这个温度值反过来又会影响损失函数,并通过反向传播更新模块自身的参数。这使得生成器在训练的不同阶段,能够自适应地生成难度层次不同的样本,从简单到困难,极大地丰富了样本的多样性。 图5 动态对抗温度模块 3. 基于熵的自适应样本加权(Entropy-Based Adaptive Sample Weighting,简称EASW) 思想:在最后的蒸馏阶段,不同难度的样本对学生网络的贡献应该不同。传统方法对所有样本一视同仁,这是不合理的。 实现:由于是无数据场景,没有真实标签,作者巧妙地使用信息熵作为衡量标准。计算教师网络输出的熵 H(PT) 和学生网络输出的熵 H(PS)。如果 H(PS) 远大于 H(PT),说明学生对该样本的预测非常不确定,这个困难样本应该获得更大的权重。权重系数 (1 - exp(H(PS)/H(PT))) 实现了这种动态调整,使蒸馏过程更高效。 二、核心创新思想
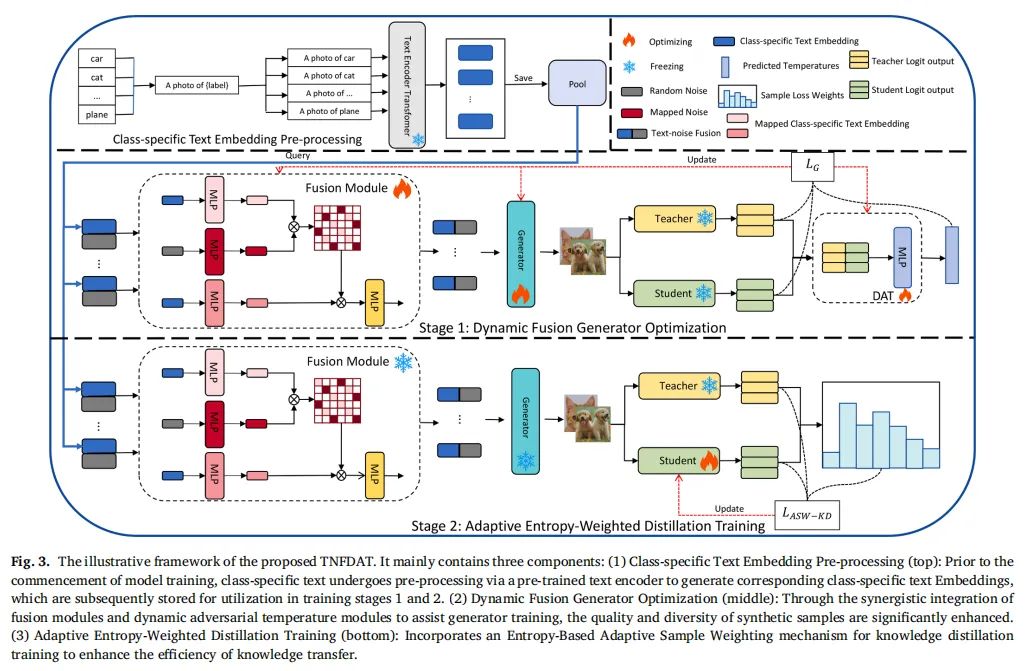
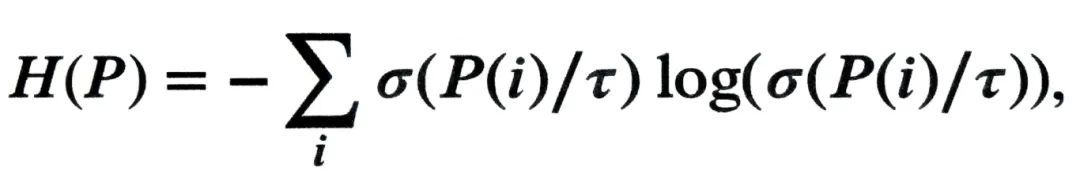
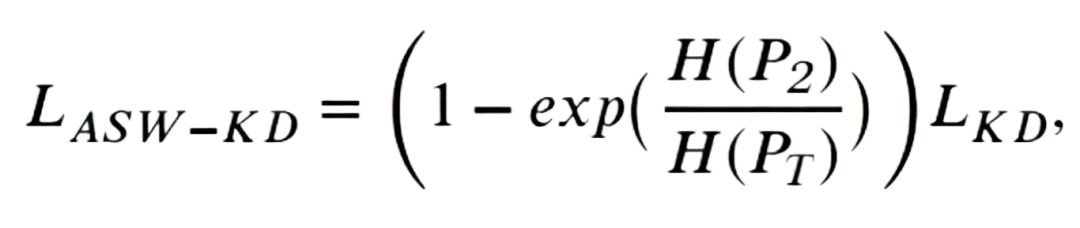
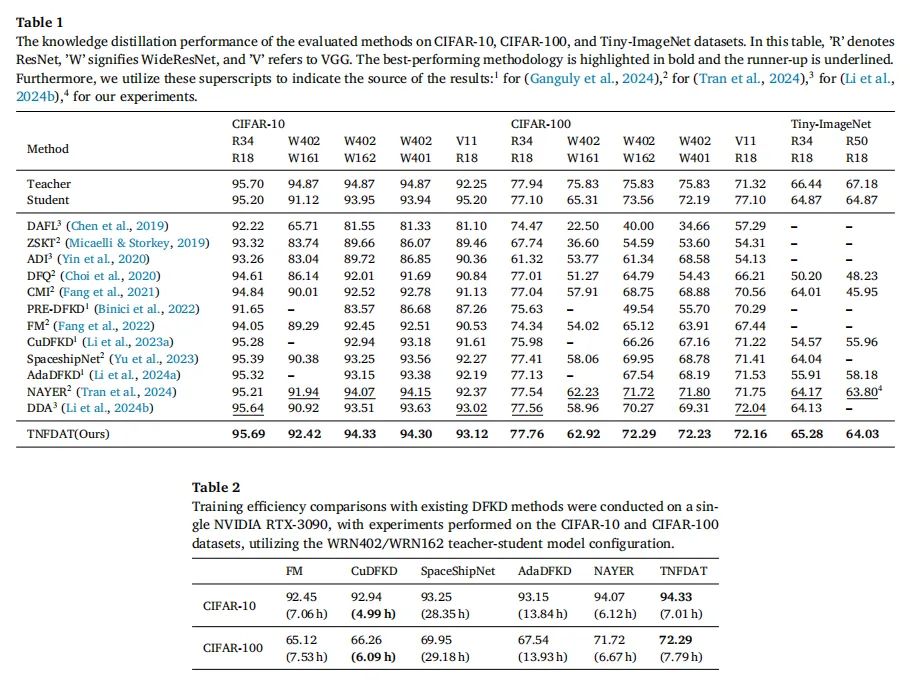
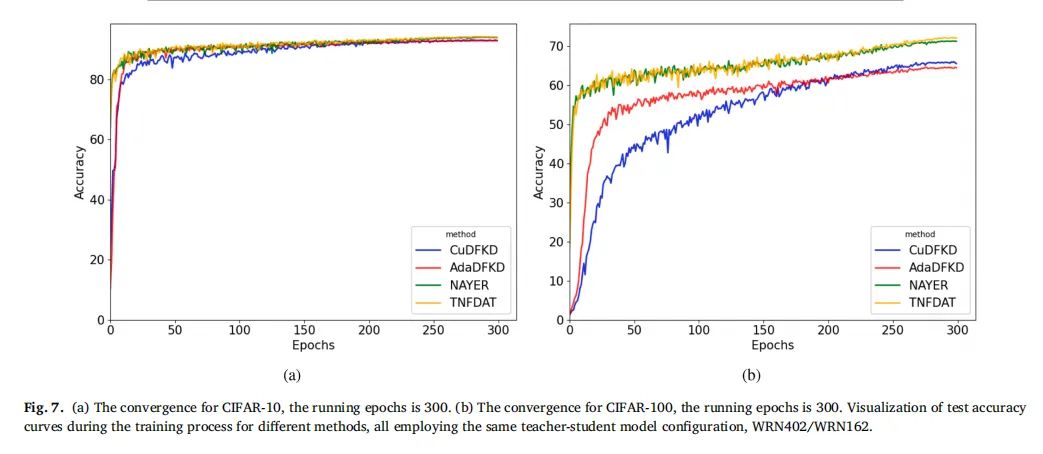
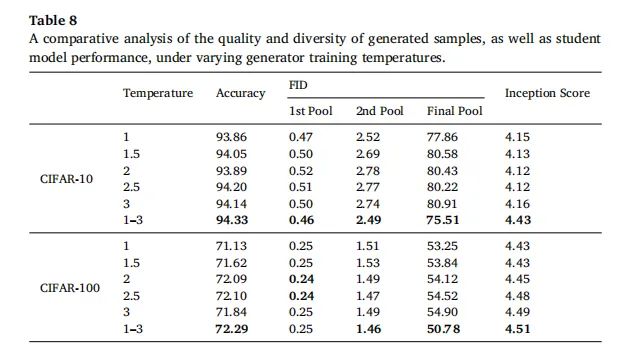
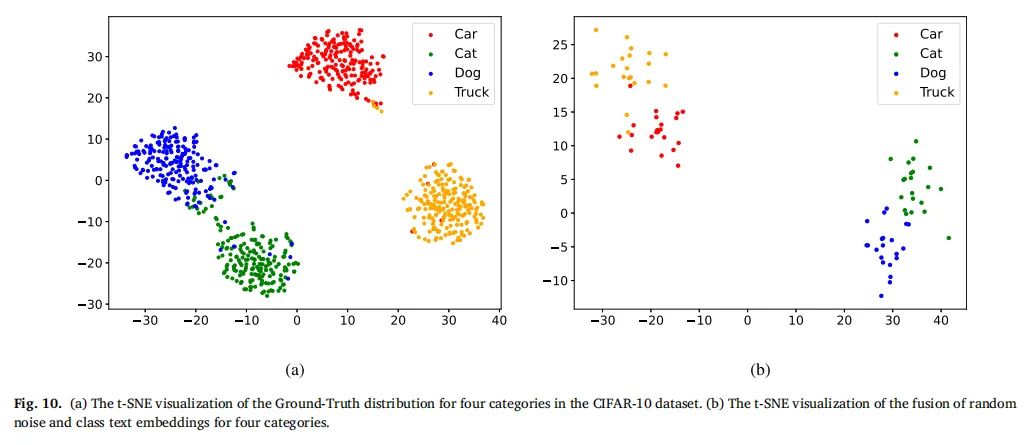
1. 显著的性能提升 在CIFAR-10、CIFAR-100和Tiny-ImageNet等多个标准数据集上,TNFDAT在多种师生网络组合(如ResNet、WideResNet、VGG)下,其Top-1准确率均达到或超过当前最先进(SOTA)方法。例如,在CIFAR-100上,将WRN-40-2的知识蒸馏到WRN-16-2,TNFDAT达到了72.29%的准确率,显著优于对比方法。 表1 多个标准数据集展现出性能方面的提升 图6 TNFDAT在CIFAR-10和CIFAR-100上的收敛表现 2. 更优的样本质量与多样性 通过FID(Fréchet Inception Distance,越低越好)和IS(Inception Score,越高越好)指标的评估,TNFDAT生成的样本在视觉保真度和多样性上都优于其他方法。论文中的t-SNE可视化也证明,其生成的样本分布与真实数据分布更为接近。 表2 FID和IS指标评估结果 图7 t-SNE可视化:文本-噪声融合让合成样本更接近真实分布 3. 更强的学生网络鲁棒性与泛化能力 论文引入了Agree@1(师生预测一致性)和概率忠诚度(Probability Loyalty)两个新指标。在这两个指标上,TNFDAT同样表现优异,证明其训练出的学生网络不仅准确率高,而且更稳定、更接近教师的推理模式,泛化能力更强。 图8 EASW 提升师生预测一致性与概率忠诚度 三、带来的巨大价值
这篇论文的核心是如何在数据缺失的情况下高效地创造和利用知识,这对AI知识管理有深刻的启示。 1. 知识的跨模态表示与融合 论文成功地将文本模态的语义知识注入到图像生成和蒸馏过程中。这告诉我们,知识管理不应局限于单一模态。在企业知识库中,可以利用多模态大模型,将文本、图像、表格等异构信息统一编码到向量空间,实现更丰富、更精准的知识检索与生成。 2. 动态与自适应知识迁移策略 动态温度和自适应加权都体现了一种因材施教的思想。在构建企业级AI助手时,面对不同背景的用户(相当于学生网络),知识传递的策略应该是动态的。对于新手用户,应提供更平滑、更确定性的答案(即低温);对于专家用户,则可以提供更具探索性和不确定性的信息(即高温)。同时,根据用户反馈动态调整不同知识片段的重要性(即自适应加权)。 3. 无数据或少数据场景下的知识生成 该方法展示了如何利用已有的元知识(即类别名称的文本描述)来反向生成训练数据。在数据隐私极其敏感的行业(如金融、医疗),当无法直接使用原始数据训练AI模型时,可以利用这种方法,仅凭对业务概念的文本描述,就能合成高保真的训练数据或知识图谱嵌入,用于模型训练或知识推理,从而在合规的前提下挖掘数据价值。 4. 知识蒸馏的自动化与智能化 论文将关键的温度超参数从人工调整变为模型自主学习,降低了使用门槛。这预示着未来知识管理系统将更加自动化。系统可以自主评估知识片段的价值、用户的接受能力,并动态调整知识传递的方式,实现智能化的知识流转和复用。 四、对AI知识管理应用的启示
TNFDAT是一项扎实且有启发性的工作。它不仅解决了DFKD领域的两个关键瓶颈(质量与多样性),更通过引入动态温度和学习型融合模块,为知识迁移和模型训练提供了新的范式。对于AI知识管理领域,其核心思想——利用语义先验知识引导生成、根据学习状态动态调整策略、区分知识难度进行加权传递——具有很高的参考和迁移价值。该论文发表在《Neural Networks》这一权威期刊上,也进一步印证了其研究工作的创新性和学术影响力。 五、总结