
奎章⋆智能知识管理平台:面向政企业务的可信知识底座
先看一个问题。
业务人员问系统:"这个事项现在的审批时限是几个工作日?"
普通知识库会返回一段流畅的话。我们的平台返回的是这样一条结果:
🧠 推理过程 Step 1 意图识别:用户查询事项审批时限 Step 2 检索召回:命中 3 篇文件,涵盖新旧两个版本 Step 3 冲突检测:发现〔2022〕7号已被〔2025〕12号废止 Step 4 采信现行版本,定位到包含第三条第二款的知识片段 答复:15个工作日。 依据:片段1 · 92.5%来源文件《XX市行政审批局关于优化XX事项办理流程的通知》(X审批〔2025〕12号),片段内容包含第三条第二款。
差别不在于哪句话说得更漂亮,而在于第二条能被点开、能被核对、能被写进办件记录里。
政务AI进入落地阶段之后,真正卡住项目的不是模型,是知识。
模型负责生成,知识库负责保证生成的东西是对的、是现行的、是查得到出处的。
云粒智慧的智能知识管理平台,做的就是这一层。
它的能力可以归结为五个词——读得懂、找得准、可追溯、管得住、用得起来:读得懂政企复杂材料,找得准现行有效的那一条,每个结论可追溯到原文的条款与页码,知识上线之后管得住不退化,并且能通过Agent和API真正接进业务里用起来。
这五项,每一项背后都是一套与市面常见方案不同的具体做法。下面逐条拆开讲。
— 01 —
读得懂:按材料类型解析,不按字数切
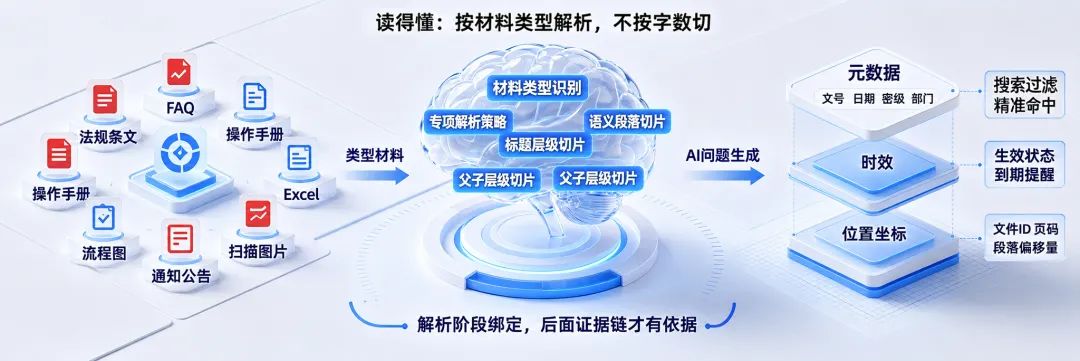
这是整个平台的地基,也是和通用RAG差距最大的一环。
通用方案的做法是:设定一个chunk size,比如512个token,滑动窗口切下去。这对小说、网页、产品手册够用,对政企材料是灾难——一条法规条款被从中间切断,一张Excel表格的表头和数据行分了家,红头公章的OCR噪声混进正文,一个FAQ的问和答落到两个片段里。后面检索再准,召回的也是碎片。
平台的做法是先判断材料类型,再选择解析策略:
材料类型 | 专项解析能力 |
|---|---|
公文 / 红头文件 | 发文字号提取、版面噪声处理、条款边界切片 |
法规 / 规章制度 | 条款编号识别、条款提取、章节上下文关联 |
FAQ 问答库 | Q-A强制绑定,作为不可分割单元入库 |
操作手册 | 图片与相关文字内容关联存储 |
业务流程文档 | 流程图OCR识别、流程节点与条件分支解析 |
表格 / 数据类文档 | 表格行列语义绑定、表格摘要、字段描述提取 |
通知公告 | 短篇材料按单一语义单元整体入库 |
扫描件 / 图文材料 | OCR识别、图文混排版面分析、结构化内容提取 |
支持 Word、PDF、Excel、TXT、Markdown、CSV、PPT 及图片批量上传、拖拽上传、URL抓取导入和手工Markdown创建;解析引擎可按文件类型分别指定,未配置的走内置引擎。
在解析的同时,平台还做三件后面会反复用到的事:
元数据结构化抽取:发文机关、发文字号、发文日期、密级、适用部门自动提取,入库即可作为检索过滤条件;
有效期管理:生效周期由人工定义和维护,系统自动标注有效期状态,到期前自动提醒,到期后知识自动失效,为"版本冲突"和"到期预警"提供数据来源;
片段级精确索引:精确定位到具体知识片段及片段内的关键内容,为答案引用、原文查看和证据追溯提供准确依据。
最后这一条看起来最不起眼,却是"可追溯"能力的物理基础。没有在解析阶段绑定位置,后面无论如何都补不出真正的证据链。
切片策略本身也可配置:语义段落、标题层级、固定长度、外部语义切片、父子层级切片,分块大小、重叠、分隔符、Token上限均可调;还可开启AI问题生成,在解析时为每个分块预生成相关问题,提高召回率。
— 02 —
找得准:三路并行召回 + 精排,不是只做向量
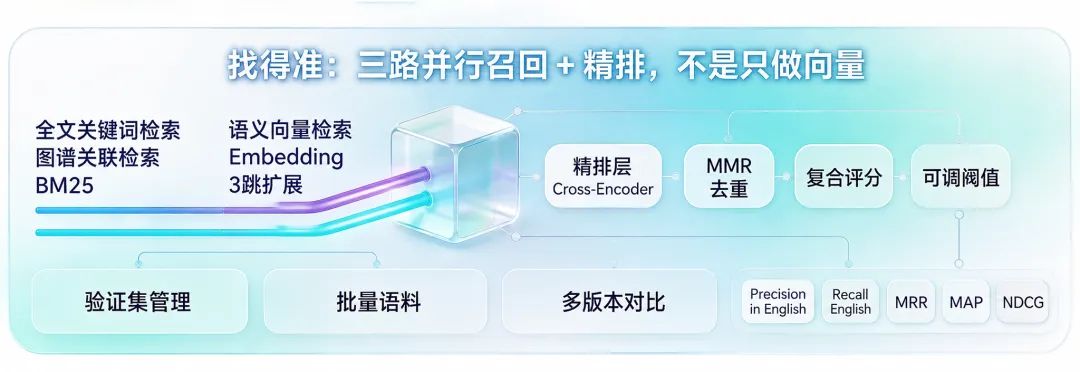
大部分"知识库"产品的检索,本质是一次向量相似度查询。问题在于:向量擅长理解口语化提问,但对"X政发〔2024〕18号"这种精确串、对实体之间的隐性关联,命中率并不高。
平台采用多路并行召回 + 加权融合 + 精排的结构:
召回层(并行)
全文关键词检索:基于BM25倒排索引,保证法条名称、文号、专有名词精确命中,配MMR去重;
语义向量检索:基于Embedding相似度,处理"办这个事要带啥"这类口语化提问;
图谱关联检索:从实体节点出发沿知识图谱关系边扩展,图查询支持不少于3跳——问"防汛",能顺着实体关系把预案、责任单位、历史处置案例一并带出来。
增强层
元数据过滤检索:按部门、时间、类型、有效期及自定义字段过滤,"只查现行有效的""只查本区的"直接在检索层生效;
查询理解与改写:意图识别、Query改写,支持视觉模型图片分析;
相似条目召回:子Chunk召回父Chunk、总结Chunk召回原始Chunk、问答Chunk召回原始Chunk——命中一个片段,把它所属的完整上下文一并取回。
精排层
Cross-Encoder 重排 + MMR 多样性 + 复合评分,向量召回数量、关键词阈值、向量阈值、重排数量、重排阈值全部可调。
调不调得好,不靠感觉。平台内置检索评测与调优模块:验证集管理、批量语料导入、内置评测语料,支持评测任务创建与执行,输出 Precision、Recall、MRR、MAP、NDCG 等检索指标,以及 BLEU、ROUGE、LLM打分等生成质量评估;支持多版本配置对比,换一个Embedding模型、调一次权重,效果是升是降,有数据说话。
这一点在验收环节尤其关键——"感觉还行"没法验收,指标表可以。
— 03 —
可追溯:返回的不是"参考来源",是坐标
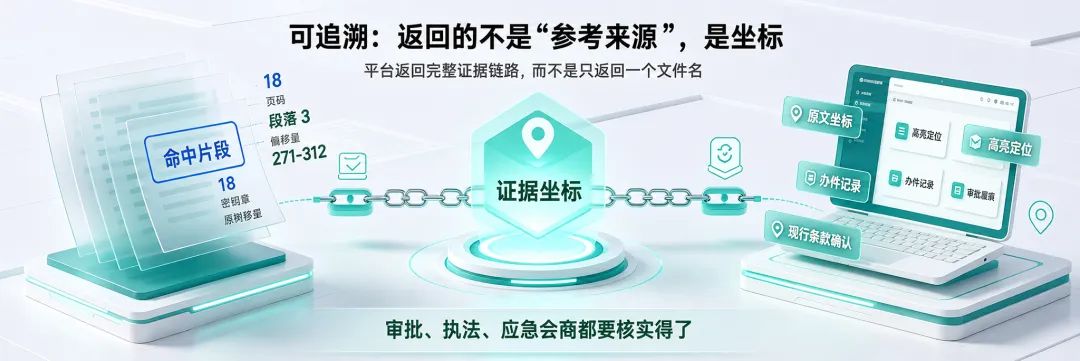
很多产品也标"支持溯源",点进去发现只给了一个文件名。文件有80页,业务人员还是得自己翻。
平台的证据片段返回的是完整溯源信息:命中片段原文、来源文件、片段内关键内容定位。上层应用拿到这组信息,可以直接实现片段原文查看和命中内容高亮。
这决定了平台能不能进高责任场景。审批人员要在办件记录里写明依据,执法人员要确认引的是现行条款而不是已废止的旧法,应急会商要确认调出的是最新版预案——这些场景不接受"看起来对",只接受"核实得了"。
— 04 —
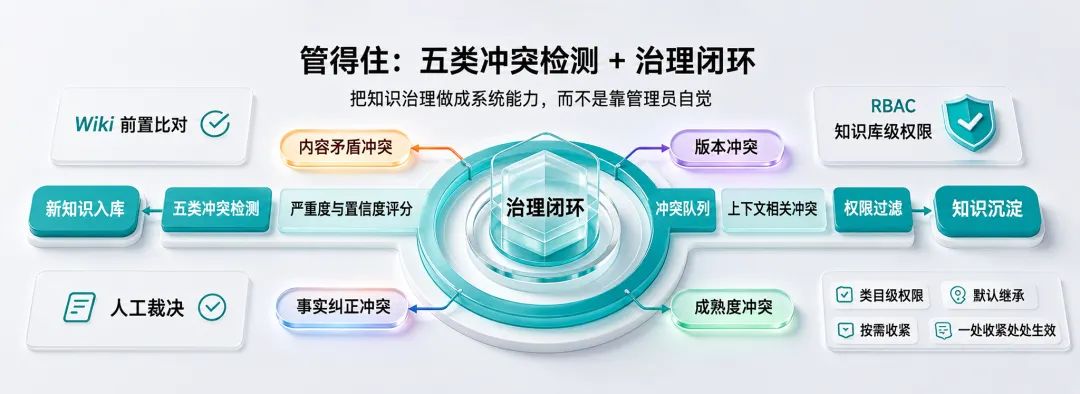
管得住:五类冲突检测 + 治理闭环
知识库项目最典型的失败方式不是上不了线,是上线半年后没人用了:政策更新只同步了一部分,旧问答还在被命中,业务部门慢慢就不问了。
平台把治理做成了系统能力,而不是靠管理员自觉。
知识冲突发现与裁决,覆盖五类:
1. 版本冲突——识别版本切换和过渡覆盖窗口期的新旧知识碰撞,支持版本有效期校验和生效时间管控;
2. 内容矛盾冲突——同一业务主题下语义互斥、结论直接对立的真实冲突;
3. 事实纠正冲突——新增知识对存量错误或过时事实的更正,辅助区分正常纠错与异常数据错误;
4. 上下文相关冲突——内容都真实但适用场景、前置条件不同的"伪冲突",标记生效边界,避免误删;
5. 知识演进——草稿、待审核、已上线、试点版本之间的结论迭代,辅助优先采纳更成熟、更新近的知识结论。
每条冲突记录严重度和置信度,提供冲突列表、冲突汇总、冲突详情,由授权人员在冲突队列中查看证据、执行处理并留痕。系统负责发现和举证,人负责拍板——这个分工是政务场景能接受的唯一分工。
新知识入库时还有入库冲突辅助检查,基于Wiki模块对待入库内容做前置比对,在入库那一刻就提示潜在冲突。
Wiki 协作层则解决知识的沉淀和体检:支持从文档自动抽取Wiki内容(MAP-REDUCE三阶段流程),生成结构化索引目录并关联原始文档、生效时间和状态;提供页面间双向链接图、断链/孤立页面/过时引用的Lint检查、知识问题标记与跟踪。
全生命周期受控:知识审核流程可总开关控制,支持创建后上线审批、主动下线审批、驳回后修改重提;配置了生效结束时间的知识临近过期自动提醒,支持延期申请和批量延期,审批通过后按新有效期继续生效。审核中心提供待审核、我发起的、全部记录三个视图,支持修改前后对比、审批历史查看、批量通过或驳回。
两级权限:知识库级基于完整RBAC体系(用户、角色、权限、工作空间隔离),可创建知识库专属角色并关联人员;类目级按2-5级类目树细化授权,遵循"默认继承、按需收紧"模型。关键是——这套权限过滤覆盖全部下游场景:搜索、智能体、RAG对话、知识图谱、冲突检测,一处收紧,处处生效,不存在"权限只管前台、后台照样能查出来"的漏洞。
— 05 —
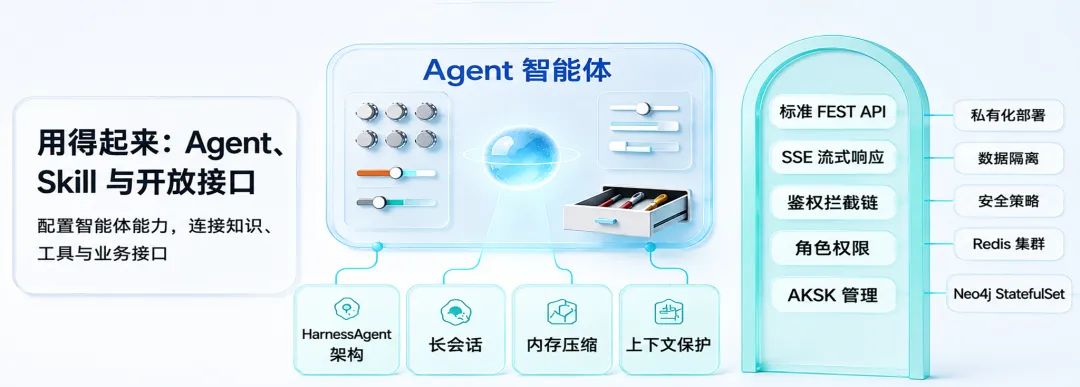
用得起来:Agent、Skill 与开放接口
知识底座本身不产生业务价值,得接到具体任务上。
Agent智能体按场景配置:运行模式(快速问答/智能推理)、大语言模型与生成参数、可访问的知识库范围、检索策略参数、工具集与最大迭代数、可调用的MCP服务、预装Skills范围、网络搜索、图片上传与视觉模型、多轮对话上下文轮数与问题改写(消解指代、补全省略)。
底层是HarnessAgent 架构,支持长会话、内存压缩和上下文溢出保护——这决定了一次复杂的材料起草任务能不能撑到最后。内置工具集包括思考、制定计划、关键词搜索、语义搜索、文档分块查看、Wiki读写、问题管理、数据分析;内置 Agent Skills 覆盖产业场景适配、引用生成、文档协作、文档分析、行业报告生成。
对外开放:标准REST API + Swagger OpenAPI文档;SSE流式响应,返回 thought、tool_call、tool_result、answer 等事件,前端可完整还原推理过程;JWT Token、角色权限、API Key、鉴权拦截链,支持AKSK凭据管理(权限范围、有效期、一键吊销)。
部署与安全:支持私有化部署,数据不出内网,模型可本地部署;租户管理员可新建空间并指定空间管理员,空间之间资源逻辑隔离;登录失败次数限制、超时退出、并发登录控制、密码有效期等安全策略可配;提供Neo4j Kubernetes StatefulSet部署配置和Redis集群接入支持。
✦ 和你可能已有的东西,差在哪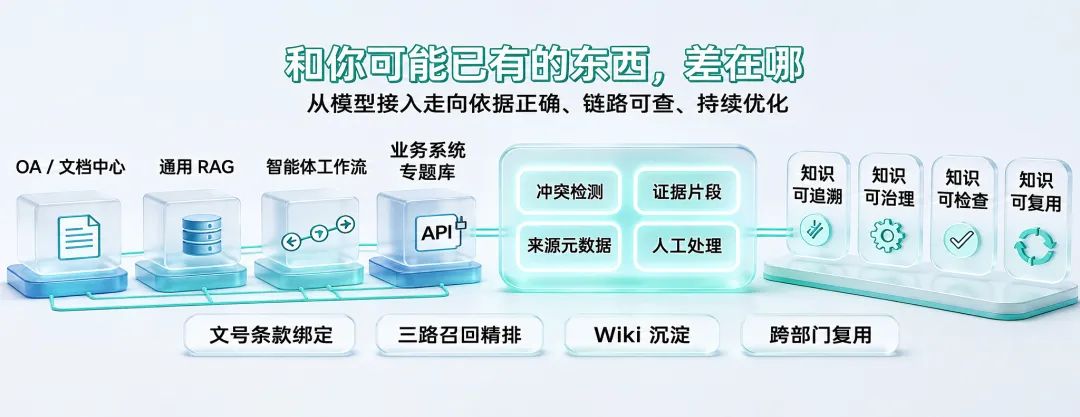
客户往往已经建了一些东西。这张表说明这个平台补的是哪一块:
你已有的 | 它解决了 | 仍然缺什么 | 本平台补什么 |
|---|---|---|---|
OA / 文档中心 | 文件归档、流程、权限 | 文件能存,但知识不能直接服务AI;文号、条款、页码、有效期无法被准确引用 | 公文法规专项解析,文号、条款、页码、有效期、来源元数据全部绑定 |
通用RAG / 云厂商知识库 | 上传、切分、向量检索、问答 | 常见问题能答,但红头文件、表格图文、法规条款和证据链处理不够细 | 三路并行召回+精排,答案带出处和证据片段,检索指标可评测 |
智能体 / 工作流平台 | 编排模型、工具、API | 流程能搭,但依赖底层知识质量,无法保证依据正确、无法处理材料冲突 | 五类冲突检测、Wiki沉淀、问题检查、人工处理、持续优化 |
业务系统 / 专题库 | 结构化数据、台账、流程 | 数据在系统里,政策、制度、案例、历史材料分散,跨部门复用难 | 场景化知识底座,一次建成、跨部门跨场景复用 |
同类产品多在解决"能不能接入模型和检索",这个平台解决的是"知识能不能被追溯、被治理、被检查、被复用"。
✦ 这些能力用在哪 1政策咨询与办事导办:12345热线、办事材料、流程导办——找准依据、指导办理,口径统一; 2汇报材料检索与起草:汇集材料、修改大纲、形成初稿、来源核验; 3法规依据与合规审查:热线工单处置依据、合同审核、制度审查——法规、案例、风险提示一并调出; 4应急预案研判与处置:水利防汛等场景,按当前条件调出相关预案条款、处置清单与历史案例; 5产业项目研判与服务:招商企业画像、园区政策匹配、供需对接、走访准备。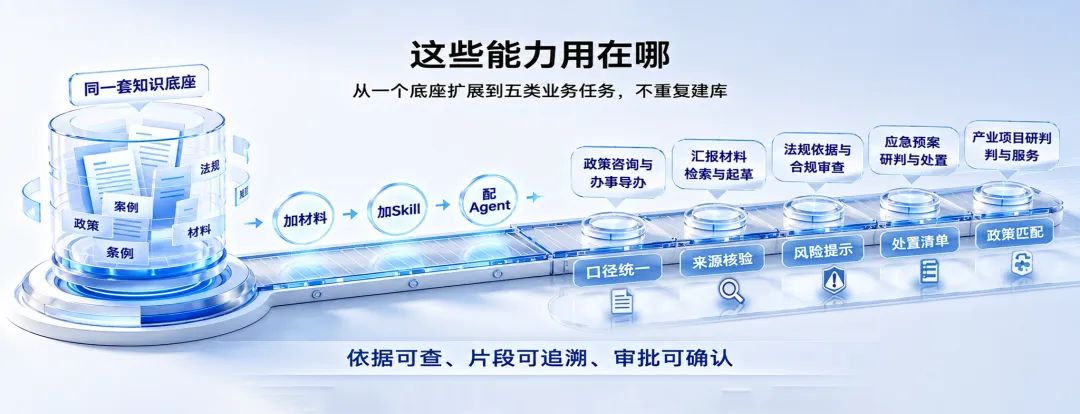
五类任务,共享同一套知识底座。扩场景的方式是加材料、加Skill、配Agent,不是重新搭一套库。
每类任务里,平台负责把依据找出来、把片段和页码摆出来、把风险和初稿备好,最终的答复、审批和签发仍由责任人确认——这也正是它敢被审批、执法、应急这类场景采用的前提。
✦ 结语
政务AI的下半场,
拼的不是谁的模型更会说话,
而是谁的答案经得起查。
当坐席的每一句答复都有出处,当会商桌上的每一份预案都是现行版本,当材料里的每一个数据都能回到原始条款和页码——AI才真正从"能演示"走到"敢使用"。
奎章 ✦ 智能知识管理平台,做的就是这件事。