
WAIC大咖说 | 星环科技杨一帆:从数字化到数智化,AI x Data 驱动的数据平台向认知底座重构
在WAIC 2026星环科技「认知涌现 · 数据新生」人工智能主题论坛上,星环科技技术副总裁杨一帆阐述了数据平台如何从“被动存储”进化为“认知底座”——通过构建知识化的数据底座,并用GPU加速数据的存储与计算,让数据更靠近智能现场。
以下为演讲实录。
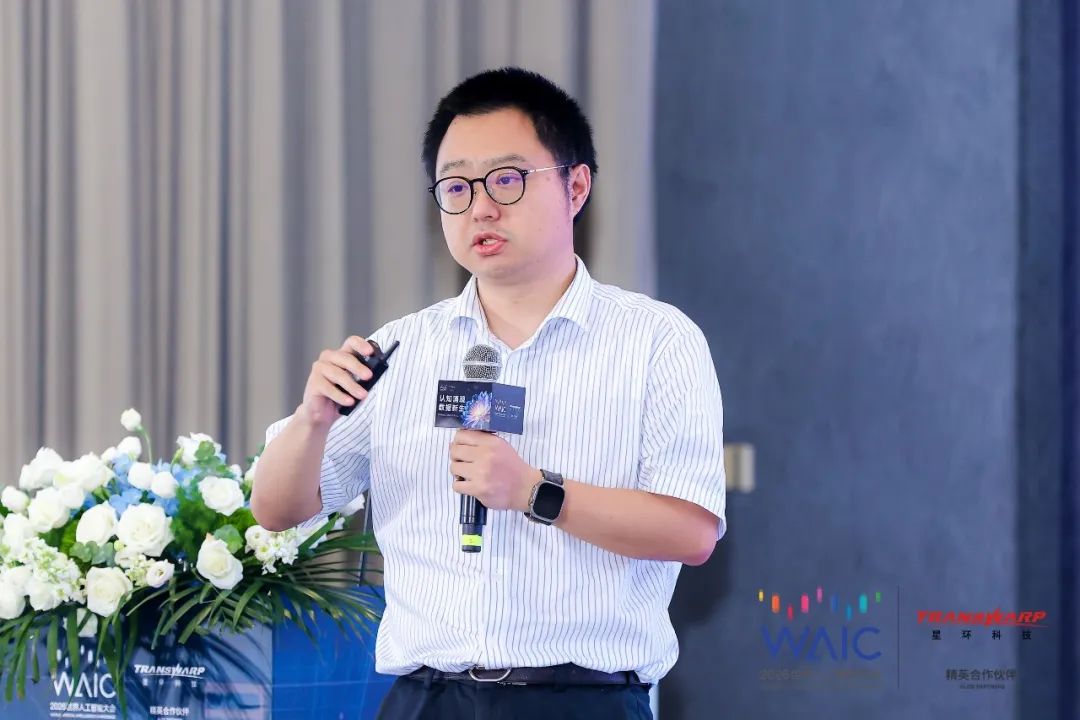
2026年,AI智能体的主题是从“陪聊”走向“出活”。这要求与其对应的数据底座也必须随之进化:从被动存储变为主动认知。本文围绕知识化数据底座与GPU加速两条主线,结合金融、能源、软件开发三大行业中的实例,描绘从数字化到数智化的完整演进路径。
不同时期实现同一个需求的三种方式
我们先看一个具体的一句话需求:
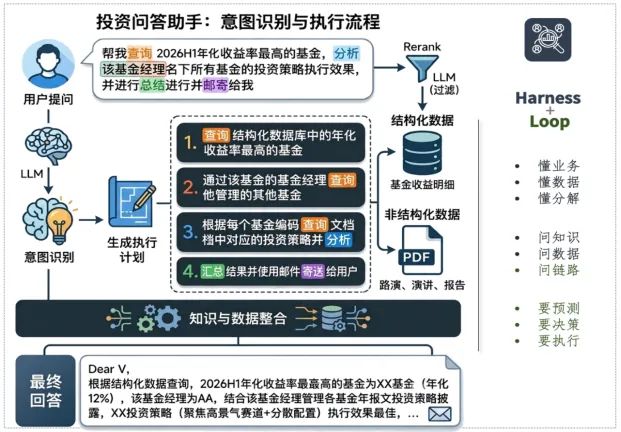
“帮我查询2026上半年年化收益率最高的基金,分析该基金经理名下所有基金的投资策略和执行效果,并进行总结后发邮件给我。”
需求拆开以后,涉及查数据、查知识、建立关联、完成分析以及执行后续动作几个环节。放在不同阶段,系统处理这个问题的方式其实完全不同。在传统(数字化)、大模型辅助(智能化)、智能体闭环(数智化时代)时代,有三种截然不同的处理模式和价值挖掘深度。
传统开发模式下,整个过程主要依赖人来推动,是“老专家”为中心的孤岛。业务人员先拆需求,再找数据、写SQL、查报告,最后整理成邮件。每个环节可能都有对应的系统,但系统之间通常是割裂的,很多工作仍然需要人来衔接。它当然能够完成任务,但效率低,而且相似需求很难直接复用。
到了大模型辅助阶段,处理方式已经发生了一次明显变化。LLM可以先理解问题,再去检索知识库、查询部分数据,并生成分析结果。相比传统方式,它已经从单纯的数据处理工具变成了能够理解自然语言、组织信息的智能助手。但这个阶段仍然存在明显边界。很多系统做到这里,本质上还是一个大模型AI Demo:它可以回答问题,也可以生成一份分析,但很难继续把后面的业务动作真正执行完。比如报告生成之后能不能自动发邮件,任务完成以后能不能记录结果,用户反馈能不能进入下一轮分析,这些往往还是断开的。
智能体(准确说:Agentic 智能体)进一步解决的是这个问题。
智能体接到任务后,会先识别目标,再生成执行计划,根据任务需要调用不同的数据、知识和工具,做出验证并反馈。以这个例子来说,它可以先查询基金收益情况,找到对应的基金经理,再进一步分析该经理管理的其他基金,读取相关策略材料,验证完备性、正确性、可追溯性,然后生成报告,最后调用邮件工具完成发送。整个过程中的数据来源、工具调用和执行结果会被记录下来,用户的后续反馈还可以作为“记忆”继续进入下一轮任务。
所以,传统系统更多地在解决“怎么响应一个明确需求”,大模型辅助工具开始解决“怎么理解并回答一个问题”,而智能体系统要解决的是“怎么围绕一个业务目标,把理解、分析和执行真正串起来”。
但智能体真正进入业务现场以后,还有一个更难的问题:它能不能正确理解业务语义。
比如这个需求里提到了“执行效果”。什么叫执行效果?
一是指标问题:是看年化收益率、最大回撤,还是夏普比率?如果是债券基金,可能更关注收益稳定性和波动控制;如果是股票基金,评价重点又可能不同。
二是服务对象问题:进一步说,即使是同一个基金经理,对于不同风险偏好的客户,“表现好”的定义也不完全一样。
这类问题是没有固定答案的。传统系统通常只能按照预设指标处理,大模型辅助工具也可以通过检索和总结给出一个相对完整的结果,但智能体系统如果真正要参与业务,就需要结合提问者的目标、业务背景和相关数据,对这些模糊概念进一步判断,必要时还要补充信息、调整分析路径。
因此,智能体带来的变化并不只是“能多调用了几个工具或者技能”。它意味着系统开始从处理单个问题,转向围绕业务目标,组织数据、知识和执行过程并形成反馈、提升闭环。
从线性流程到智能协同闭环
过去企业软件的建设方式,大多是一条比较清晰的线性流程:业务提需求,产品写方案,研发完成系统建设,经过测试以后上线,再交给运营和业务人员使用。然后下一轮需求——高度固定、有明确KPI、满足强监管,本质上是流水线。
现在则变成了智能协同闭环:从业务目标倒推拆解,数据角度回补,智能体设计不停演化,因此智能体需要围绕业务价值目标编排资源,依托Memory记忆、Tool工具、Skill技能、Policy策略四类能力组织形成业务、数据、智能体飞轮。
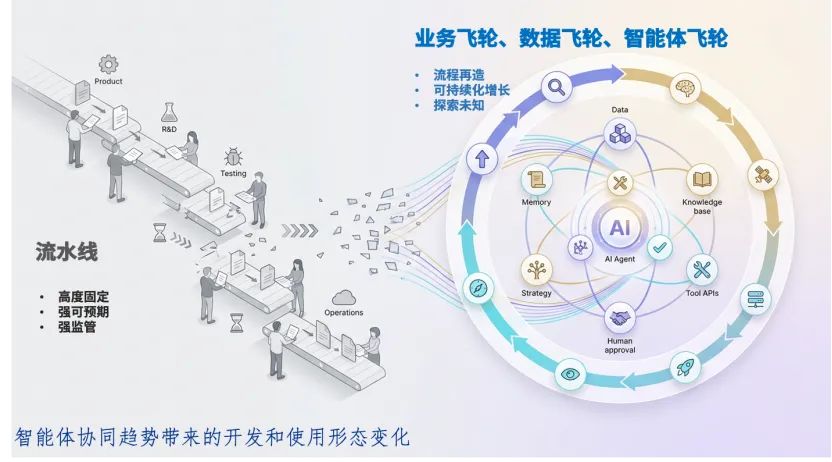
这三个飞轮联动起来,形成了持续学习、持续执行、持续优化的业务能力。智能体框架也随之演变:从静态输入到动态上下文,从被动响应到智能体化,会话(Session)具有长上下文、多轮、多模态特点,数据冷热温分层,高动态高并发,流程可定制、可解释、迭代快。
简而言之:过去交付的是一个项目、一个系统、一个功能;未来交付的是一个持续学习、持续执行、持续优化的业务能力。
智能体进入业务现场,
数据基础设施必须回答四个问题
以能源电力行业中的电力设备预测性运维为例。假设变电站的红外巡检机器人发现某个接头温升异常,通常做法根据传感器或者红外图像做判断,形成工单并处置就完成了业务。但从更系统的运维视角,还可结合设备台账、历史工单、传感器时序数据、检修规程、备件库存以及派工情况,综合判断故障风险的真正根因在维护SOP、设备本身缺陷或者时空因素等,并进一步给出运维建议,以及形成新的可验证SOP。
当智能体真正进入这样的业务现场以后,数据基础设施至少要解决四个问题。
第一,AI能不能真正理解企业数据?
企业里的数据并不是天然带有业务语义的。比如设备、部件、缺陷、温升、风险等级和检修动作之间,本身存在明确的业务关系。如果只是把这些数据分别存进数据库或者知识库,AI看到的仍然只是一个个孤立的数据对象。因此,需要通过本体(Ontology)、知识图谱以及多模态理解,把这些概念、实体和关系组织起来,让AI知道“这条数据在业务上怎么定义、关联;在什么环境下如何操作,后果是什么”。
第二,AI能不能实时调用高价值数据?
设备故障判断往往有很强的时效性。红外图像刚发现异常,智能体就需要进一步查询实时传感器数据、最近一次检修记录以及历史故障情况。如果这些数据还停留在批处理链路里,等数据准备好以后,最佳处置窗口可能已经过去。因此,底层不仅要支持传统的数据分析,还要能够同时处理向量、时序等不同类型的数据,让智能体在执行过程中能够从多模、多来源系统中低延迟地获取所需信息。
第三,智能体为什么做出这个判断,能不能将根因说清楚?
如果系统判断某个设备属于高风险,运维人员一定会继续问:依据是什么?是红外图像里的温升异常,还是某项传感器指标超过阈值?有没有参考历史故障记录或者检修规则?所以,智能体的执行过程不能是一个黑盒。它查询过哪些数据、调用过哪些规则、使用了什么模型、最终依据哪些证据得出结论,都需要通过追溯、数据血缘、证据链和审计机制保留下来。只有这样,智能体的结果才能真正进入生产系统。
第四,这套系统能不能从实际结果中持续学习、迭代?
预测性运维的价值不只在于给出一次判断,更重要的是维修完成以后,实际结果能不能重新回到系统里。例如这次判断是不是准确、最终发现了什么故障、采取了什么维修措施、效果怎么样,这些结果都可以继续更新缺陷库、规则、模型和派工策略。
只有把业务结果持续反馈回来,智能体下一次遇到类似问题时,才有可能做出更准确的判断。对企业来说,所谓“持续进化”,最终还是要落到这些可以记录、评估和验证的业务结果上。
数据的角色:从记录业务到驱动业务
银行对公展业是一个很典型的场景。同一家企业客户,在不同阶段,数据扮演的角色并不一样。
数字化阶段,数据首先用于记录业务,把拜访记录、授信材料等沉淀到CRM和核心系统中。
智能化阶段,数据开始辅助决策,通过BI和数据仓库分析客户行业、交易流水和授信风险。
数智化阶段,数据进一步进入Agent的执行链路。Agent可以结合客户画像、交易数据、产品知识和风险规则,识别客户机会、生成拜访策略、匹配产品方案,并根据后续业务结果持续调整。
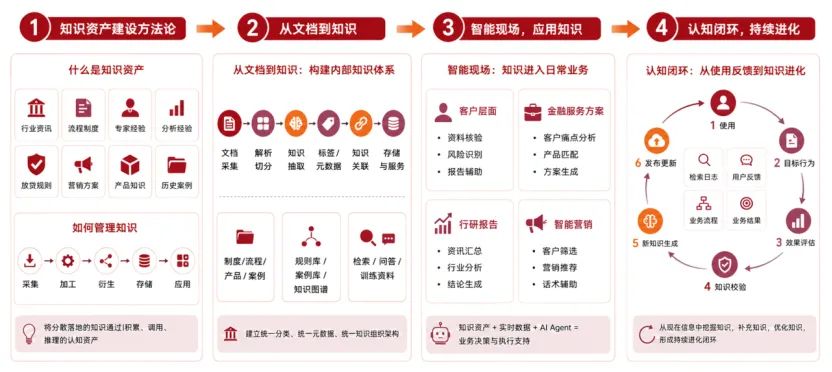
所以,数据的角色正在从“记录发生了什么”,逐步走向“帮助判断下一步该做什么”。
数智化也不是简单地在办公软件UI上增加一个聊天入口。对公展业真正需要解决的,是营销机会、客户需求、风险判断和合规要求如何在同一个业务过程中协同起来。
传统数据平台的五个断点
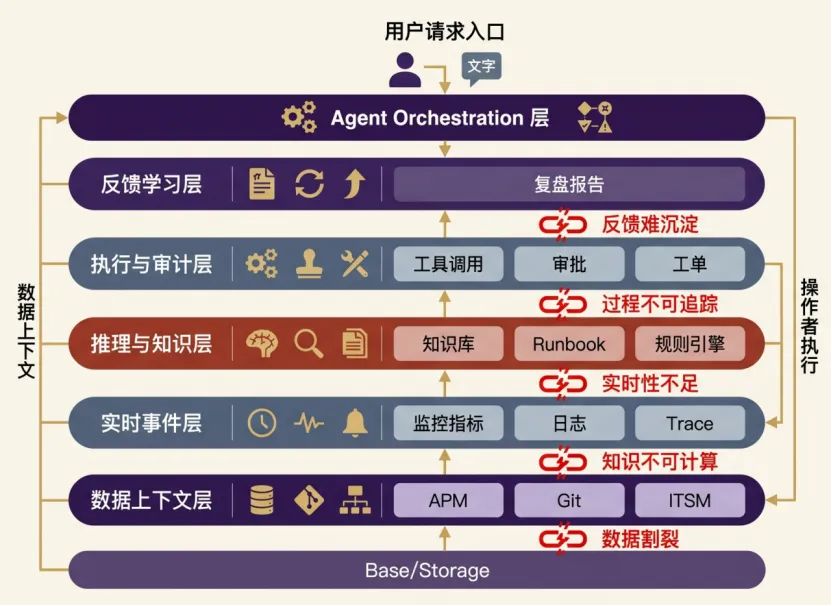
再看软件运维场景。假设要“定位昨晚核心交易系统的异常原因,结合日志、指标、变更记录、代码提交和知识库,生成修复建议并创建工单”,传统数据平台通常会遇到五个断点和潜在解决方案:
数据割裂:日志在APM、指标在监控系统、代码在Git、工单在ITSM,Agent很难获得完整上下文,这类各业务系统独立产生的半结构数据缺乏统一的主数据管理机制,需要业务和技术两方面的统一语义层建设;
知识难以直接调用:很多经验仍停留在文档和人脑中,仅仅做向量化存储,还不足以表达复杂的业务关系和处理规则,需要深度结构化进行定义、治理、质量控制;
实时性不足:数据链路仍以批处理为主,异常发生后无法及时完成分析和响应,与能源电力行业的预测性运维遇到的困境一样,既需要对单一非结构化数据分析能力做增强,也需要解决多模、多来源存、算、分析能力不足的问题;
过程不可追踪:智能体查了哪些数据、调用了哪些规则、为什么得出当前结论,缺少完整记录,需要建立SOP、可量化判别标准等操作性本体,继而完善运维系统持续集成开发(CI/CD);
反馈难以沉淀:修复结果没有回流到知识、规则和模型中,类似问题下次仍可能重复处理,急需探讨和解决人在环(HITL)的自迭代问题(SI)。
因此,很多智能体作为Demo虽然能够完成一次任务,但真正进入生产环境以后,问题往往出在数据、知识和执行链路没有真正打通。要解决这些断点,需要进一步把企业的数据、知识和反馈组织成可持续运行的认知闭环。
认知底座:两条核心路径
认知底座不只是简单替代湖仓、数据库或AI平台,而是把它们重新组织成智能体可调用、可治理、可进化的能力体系。
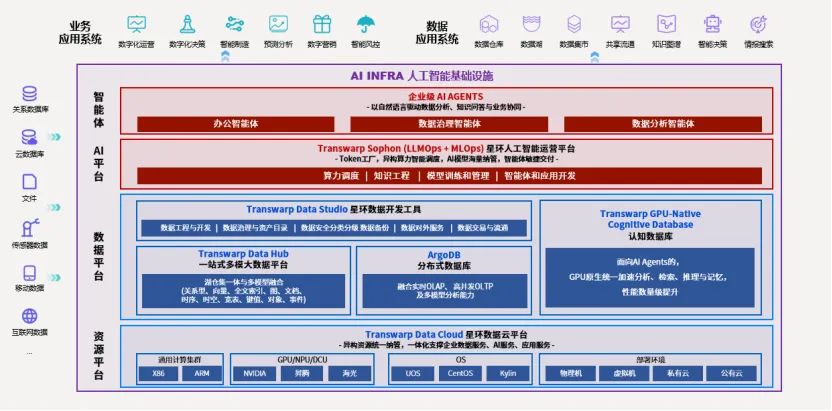
在星环的产品体系中,有完整的产品矩阵支撑这种架构:办公智能体Co-worker、数据治理智能体Transwarp Astro;Transwarp Sophon(LLMOps + MLOps)星环人工智能运营平台,负责Token工厂、异构算力智能调度和AI模型海量纳管;Transwarp Data Studio星环数据开发工具,覆盖数据工程、治理与安全分类分级;Transwarp Data Hub一站式多模大数据平台,实现湖仓集一体与多模型融合;ArgoDB分布式数据库,融合实时OLAP、高并发OLTP及多模型分析能力;Transwarp GPU-Native Cognitive Database认知数据库,面向AI Agents,GPU原生统一加速分析、检索、推理与记忆,性能数量级提升;Transwarp Data Cloud星环数据云平台,异构资源统一纳管,支持X86、ARM、GPU/NPU/DCU(NVIDIA、昇腾、海光)等多架构部署。
知识工程:深度治理知识,
而不是仅把文档丢给大模型归档
知识工程、知识库建设,作为智能化的数据底座,其核心目标是将分散在组织内部的经验、规则与数据,转化为可治理、可复用的认知资产。但当前的很多实践中,错误地:1.把整篇文档直接交给大模型(“文档仓库”模式);2.解析完后直接塞给大模型提示词(朴素RAG模式)。
从方法层面看,完整的过程通常需要六个环节和更多的步骤。
第一:多源数据的接入、解析。原始知识往往以多种形态存在,比如:图文表混排的文档、嵌入表格的参数信息、音视频文件等。如果这些内容无法被正确读取,后续所有工作都会失去可靠输入。因此,第一步需要通过版面解析、表格识别、OCR、语音转文字、VLM等技术,将不同来源、不同格式的原始材料转化为结构清晰、可处理的文本与数据对象。
第二:语义申明、表述、验证。这是整条链路的枢纽,在第一条前中后都会发生。企业数据本身并不天然携带业务语义,所以{概念、实体、事件}之间的边界与关系需要预先定义并框定逻辑。通过语义本体,可以明确领域内的核心概念、实体类型、关系以及事件类型,并由受控词表(如前电力设备运维中实例)统一治理标签与关系类型。只有先建立语义边界,后续的实体与关系抽取才有依据,而不是在无约束的文本中盲目识别。
第三:知识ETL清洗、加工。不同类型的文档承载知识的方式不同,需要采用不同的加工策略。长文本适合智能切片,表格型内容适合行级解析,问答类材料适合问答对抽取,制度类文档需要结构化提取,标准、流程说明书、研究报告等内容则可以深度结构化进行实体与关系抽取。通过按文档类型和业务类型自动匹配加工模板,最终产出语义统一的子表结构,为后续检索与推理提供一致的数据形态。
第四,知识增强。 原始抽取结果往往不足以支撑高质量应用,还需要利用数据标注、抽取、生成、合成技术进一步补充语义特征。例如,思维链(CoT)标注、知识蒸馏标注、抽取关键词与实体、生成分章节乃至层级的摘要、为表格和图片生成描述等。知识增强操作能够提升知识的可检索性、可理解性与可组合性。
第五,审核、验证与诊断。 知识库通常需要回答两个阶段的问题:知识是否被正确检索,以及检索到之后是否被正确使用。例如:通过会话内的提问与引用来源检查,可以观察答案的生成质量;通过召回测试查看原始命中与相关性分数,可以判断检索环节是否有效。两者结合,能针对“没检索到”与“检索到了但没答好”这两类问题做根因分析与优化,并提供关键可追溯证据。
第六,智能体可调用。 知识工程最终要服务于上层技术(存、算)和业务(用、更)应用。底层需要支持混合检索、重排、跨知识库检索等能力,并将这些能力封装为标准的知识服务接口,供智能体、业务系统或其他应用消费。只有这样,知识库才能从静态资源转变为可动态调用的基础设施。
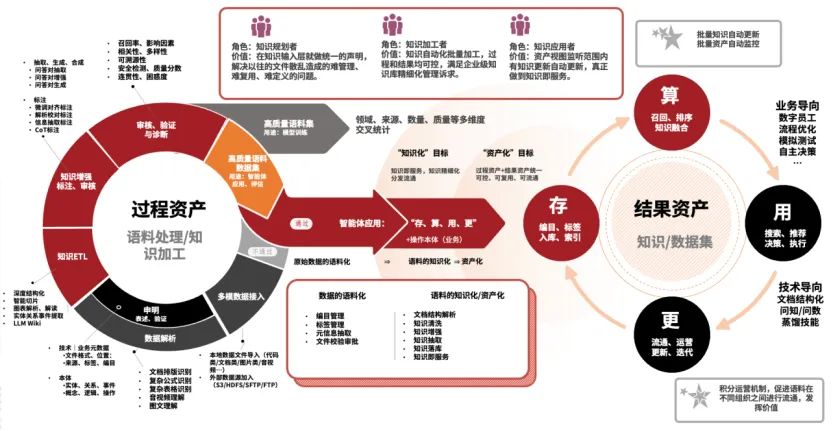
以使用行业教材铺底基础语料为案例:教材中有图、文、表,且互为映射。此时,知识工程不仅需要正确解析内容,还要重构内在逻辑关系,和所关注的业务知识体系和本体对齐。星环Sophon LLMOps的知识工程产品Knowledge Lodge通过计划、执行、应用知识智能体把上传、解析、方案确认、建库与验证收敛为一次可确认的任务,实现语料到知识到资产的自动化工作流,关键技术指标包括:文档解析200页/秒,建库效率提升80%,单知识库支持10亿条目,10+召回策略达到SOTA水平。
八步认知闭环与Agentic治理
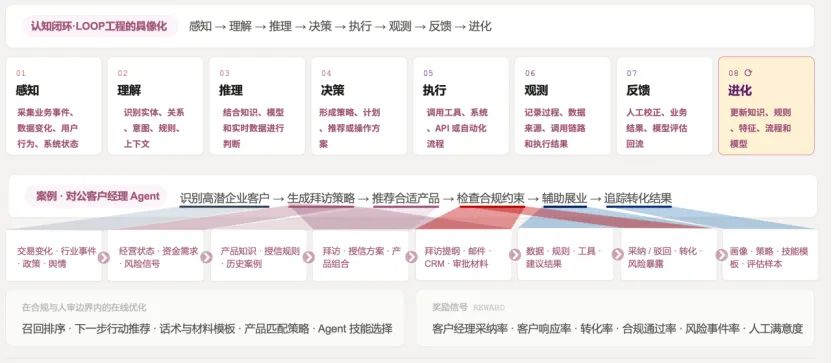
以对公客户经理智能体为例,一次完整的认知闭环可以分为八个步骤:系统首先通过交易变化和行业事件进行感知,进一步理解客户的经营状态和资金需求,并结合产品知识与授信规则进行推理,在此基础上形成客户拜访方案和产品组合决策,随后生成拜访提纲、邮件并完成CRM记录等执行动作;执行结果再通过相关数据、规则及建议结果进行观测,并根据客户对建议的采纳或驳回情况以及最终转化率形成反馈,持续更新客户画像、营销策略和技能模板,从而实现整个营销过程的不断进化。
但企业级智能体的持续优化必须有明确边界。尤其是在金融场景中,权限、合规、人审和风险控制都不能缺位。Agent可以在安全可控的环节根据反馈不断调整,但涉及授信、风险决策等关键环节,仍然需要遵循既定规则和人工审核机制。
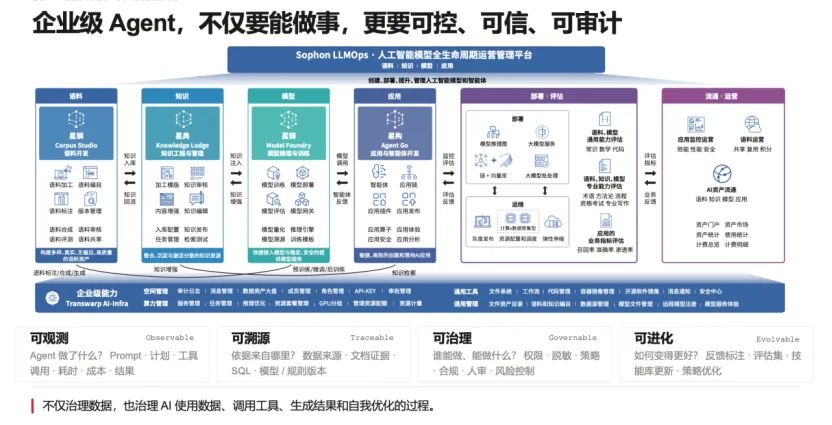
因此,智能体进入生产环境后,至少要具备四方面能力:可观测,能够记录提示词、任务计划和工具调用过程;可溯源,能够追踪数据来源、文档证据和模型版本;可治理,明确权限、脱敏、合规和人审边界;可进化,把业务反馈沉淀到评估集、知识和技能中,持续改善后续执行效果。
结语:让数据靠近智能现场
从数字化到数智化,数据平台的核心使命正在重构——这不是局部升级,而是AI时代企业认知基础设施的重构。三件事至关重要:知识化的数据底座让数据成为认知资产;GPU加速的计算底座让高价值数据靠近智能现场;完整的认知闭环支撑企业持续智能生产。
落地分四步:以高价值业务场景为切入点,构建本体与认知资产,推动高价值数据进入Agent执行链路,并形成可观测、可治理、可持续进化的业务闭环。当前很多老旧Demo和烟囱式架构正在被下线重构,整个行业不是回归平常,而是拥抱智能体新时代。
未来的企业竞争力,不只取决于有没有数据,而取决于能否把数据组织成认知资产,并让它进入智能现场。