
喜报!飞渡联合团队荣获ECCV 2026 具身感知挑战赛世界季军,突破具身智能感知边界!
1小时的真实步行视频、218段真实影像——当全球顶尖多模态模型在这条“超长赛道”上接受极限测试时,飞渡科技联合研究团队交出了75.4%总体准确率的答卷,在AI顶会ECCV 2026具身智能赛道中获得世界季军。
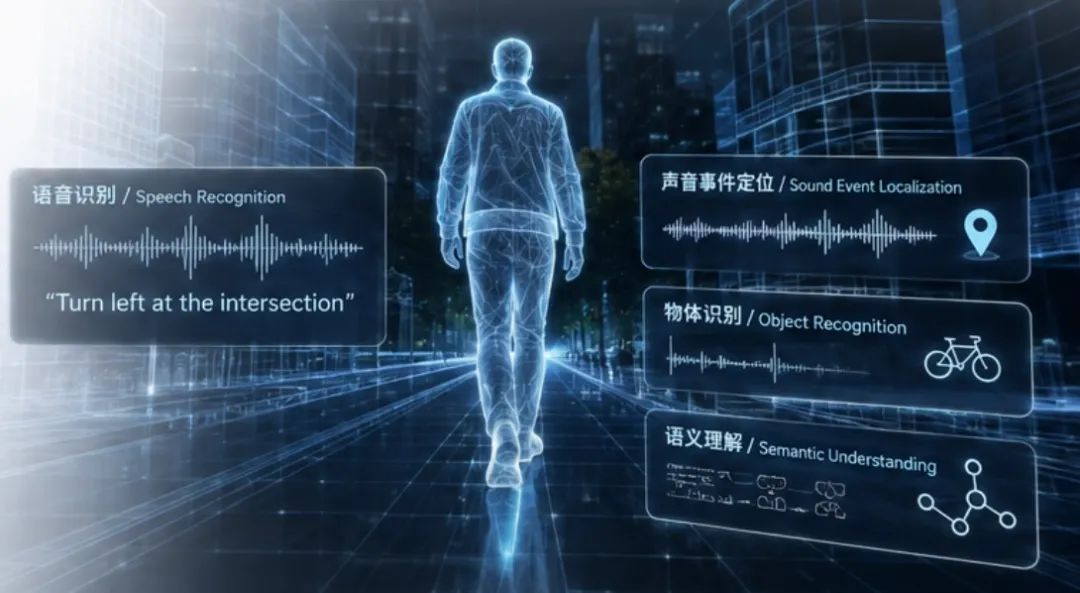
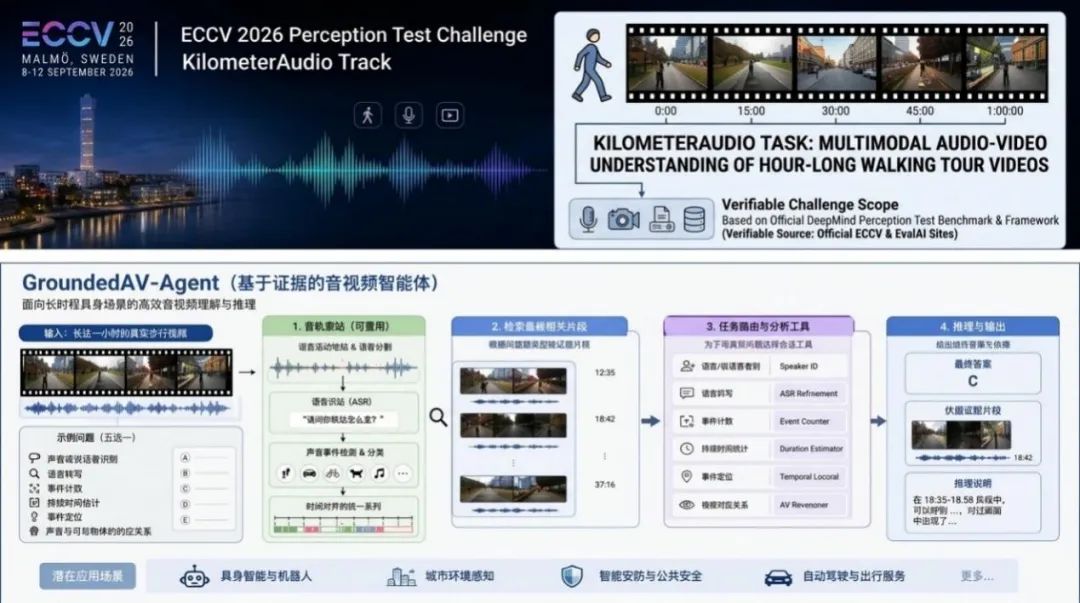
这不是一次普通的竞赛排名。它意味着:机器在真实物理世界中实现边走、边听、边看、边理解的连续感知与认知,正在从科幻走进工程现实。而这,也是飞渡科技进军具身智能赛道的又一重要里程碑。 巅峰时刻 站上世界领奖台,中国空间智能力量再次被看见 ECCV(欧洲计算机视觉国际会议)是计算机视觉领域最重要的国际会议之一,每两年举办一届,汇聚全球学术界与产业界的最前沿成果。今年,ECCV 2026在瑞典马尔默举行。会议期间举行的Perception Test Challenge(感知测试挑战赛)围绕多模态模型的空间智能、具身感知、长视频理解和现实世界感知能力设置多项高难度任务,是全球具身智能与多模态感知领域的“华山论剑”。 在本届赛事新增的长视频视听理解赛道——KilometerAudio(感知测试)赛道中,飞渡科技所率领的联合研究团队从全球参赛队伍中脱颖而出,获得世界季军。 极限赛场 1小时长视频、218段真实影像、500道“灵魂拷问” KilometerAudio,顾名思义: kilometre级的视频时长、以Audio为关键线索。这条赛道聚焦具身场景下的超长视频音视频联合理解——要求模型从长达1小时的真实步行视频中,定位关键声音、识别语音内容,并结合第一视角画面完成推理。 官方测试集的残酷之处在于: 218段真实步行场景视频,全部来自连续移动的第一视角拍摄; 500道五选一问题,覆盖声音识别、说话者识别、语音转写、事件计数、持续时间估计、事件定位、声画对应关系等多个维度; 没有剪辑、没有摆拍、没有“考试重点”——考验的是模型对真实世界未经修饰的时空感知与跨模态关联能力。 一句话:这是在考验模型 —— 能否在长达1小时的连续行进场景中,完整感知并记忆全程的所有事件与信息。 技术破局 GroundedAV-Agent 像侦探一样“找证据”,而不是“看完全片” 面对这道世界级难题,团队给出的答案是——GroundedAV-Agent(基于证据的音视频智能体)。 与传统方法对整段视频进行高密度“暴力分析”不同,GroundedAV-Agent的思路更像一位经验丰富的侦探: 先建索引:为完整音轨建立可复用的语音与声学索引,把1小时的多媒体数据变成一座可检索的“证据图书馆”; 再查证据:根据具体问题,精准检索最相关的时间片段,而不是全程“死磕”; 分工推理:系统自动区分语音识别、声音类别、事件计数、时长估计、视听联合判断等不同问题类型,为每类问题调用最适配的分析工具。 这套“先索引、再检索、后推理”的架构,让模型实现了对长时程具身音视频信息的高效理解与推理——最终在官方测试集上取得75.4%的总体准确率。 这一结果也揭示了一个重要趋势:在长视频视听理解及具身智能任务中,除了模型本身的感知与推理能力,如何从海量时空数据中高效检索并定位关键证据,同样是决胜的关键。这正是通往世界模型的必经之路。 ▲图 GroundedAV-Agent(基于证据的音视频智能体) 峥嵘底座 从世界模型到空间智能基础设施 赛场上的每一次突破,背后都是底座能力的长期沉淀。 飞渡科技的峥嵘大模型,是全球首个通过国家备案的工业级空间智能大模型,拥有空间生成、空间理解、空间推理、空间决策核心技术体系,具备物理世界“认知和动态演化”能力,可赋能100+个AI驱动应用场景。 以卫星、无人机、具身智能感知为入口,峥嵘大模型构建起“空间生成—理解—推理—决策”全链路核心能力的基础平台,主要定位解决工业级精度下对物理世界“认知、模拟、推演、改造”的需求——这正是飞渡科技所打造的空间智能基础设施。 此次GroundedAV-Agent在KilometerAudio赛道上的验证,与峥嵘大模型的技术体系一脉相承:让机器不只是“看见”世界,而是“看懂”世界、“听懂”世界,进而理解并预测世界的动态演化——这正是世界模型的核心内涵。 未来已来 实现真实场景下的自主感知、自然交互与智能对话 从实验室走向物理世界,相关技术未来有望进一步应用于具身智能、机器人感知、城市环境感知等场景。让机器深度感知物理世界、自然与环境交互联动 —— 这不是一句口号,而是飞渡科技正在一步步兑现的技术路线图。 世界季军,只是起点。空间智能的星辰大海,飞渡科技正在路上。